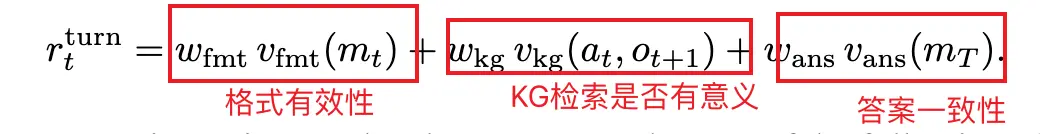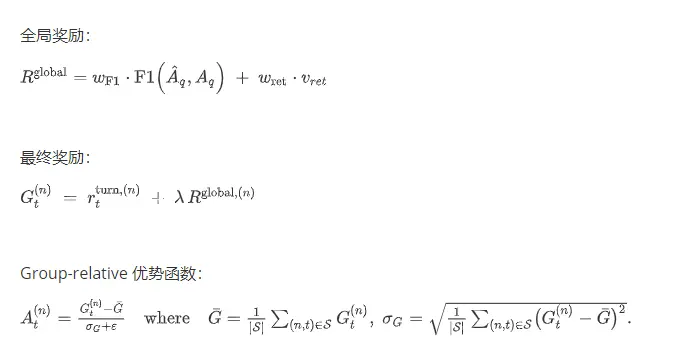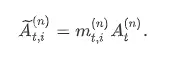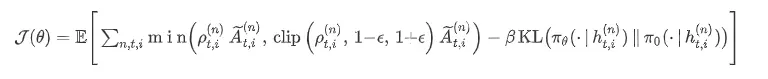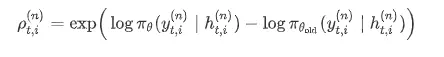<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" xml:lang="zh-CN"><generator uri="https://jekyllrb.com/" version="4.4.1">Jekyll</generator><link href="https://xuduyinuo.cn/feed.xml" rel="self" type="application/atom+xml" /><link href="https://xuduyinuo.cn/" rel="alternate" type="text/html" hreflang="zh-CN" /><updated>2026-10-22T13:09:25+08:00</updated><id>https://xuduyinuo.cn/feed.xml</id><title type="html">Xudu</title><subtitle>记录技术探索、观影感受与日常思考。</subtitle><author><name>Xudu</name></author><entry><title type="html">Redis 修炼手册~</title><link href="https://xuduyinuo.cn/redis/" rel="alternate" type="text/html" title="Redis 修炼手册~" /><published>2026-10-19T00:00:00+08:00</published><updated>2026-10-19T00:00:00+08:00</updated><id>https://xuduyinuo.cn/redis</id><content type="html" xml:base="https://xuduyinuo.cn/redis/"><![CDATA[<p>时不时打个补丁，让自己的知识体系少点漏洞。</p>

<!-- more -->

<h2 id="1-缓存穿透缓存击穿缓存雪崩">1. 缓存穿透、缓存击穿、缓存雪崩</h2>

<p>这三个都是缓存失效，请求全部打到数据库的场景；</p>

<p>缓存穿透：查询缓存和数据库中不存在的数据，由于一直查不到数据导致不能回写缓存，可能导致数据库挂掉。</p>

<p>解决方法：</p>

<p>参数入口校验合法性</p>

<p>缓存空值，空值设置过期时间短一些，避免内存撑爆</p>

<p>使用布隆过滤器拦截非法key，将所有合法数据都加载到布隆过滤器中，布隆过滤器对于存在可能误判，但是能确认一定不存在</p>

<p>缓存击穿：当缓存中的某个热点key过期的瞬间，大量请求涌进来全部打到数据库，导致数据库崩溃。</p>

<p>解决方法：</p>

<p>使用互斥锁，当缓存失效时只让一个请求线程去加载数据库并回写缓存，成功后再释放锁；</p>

<p>设置缓存数据逻辑过期，将缓存中的value值设为hash类型，在其中设置过期时间戳，当请求来的时候判断数据是否过期，判断过期的话加锁并启动第二个线程从数据库中加载数据并回写缓存，对数据一致性不敏感的话第一个线程可返回缓存中的旧数据。</p>

<p>缓存雪崩：缓存中的大批量key同时过期，或者Redis整个挂掉了，请求全部打到数据库，导致数据库崩溃。</p>

<p>解决方法：在过期时间的基础上增加随机值，将缓存key的过期时间分散开</p>

<h2 id="2-缓存与数据库保证一致性">2. 缓存与数据库保证一致性</h2>

<p>1、先更新数据库，再删缓存</p>

<p>2、缓存延迟双删：先删缓存，更新数据库，延迟再删一次缓存</p>

<p>3、Binlog 异步更新：用Canal监听mysql的Binlog日志，使用消息队列异步更新缓存。</p>

<h2 id="3-redis-分布式锁">3. Redis 分布式锁</h2>

<p>Redis 实现分布式锁的核心就是 SET key value EX seconds NX （NX = Not eXists，XX = eXists）命令配合 Lua 脚本。加锁时用 NX 保证互斥，EX 设置过期防止死锁；解锁时必须用 Lua 脚本先校验再删除，保证原子性。</p>

<p>加锁流程：</p>

<p>1）客户端执行 SET lock_key uuid EX 30 NX</p>

<p>2）Redis 检查 lock_key 是否存在</p>

<p>3）不存在则设置成功，返回 OK，加锁成功</p>

<p>4）已存在则返回 nil，加锁失败</p>

<p>解锁流程：</p>

<p>1）客户端执行 Lua 脚本</p>

<p>2）GET lock_key 获取当前值</p>

<p>3）判断值是否等于自己的 uuid</p>

<p>4）相等则 DEL lock_key，解锁成功</p>

<p>5）不相等则返回 0，说明锁不是自己的</p>

<h2 id="4-redisson-分布式锁">4. Redisson 分布式锁</h2>

<p>Redisson 分布式锁的核心就是用 Redis 的 Hash 结构 + Lua 脚本保证原子性，再加上一个后台线程做自动续期。</p>

<p>加锁流程</p>

<p>加锁时 Redisson 执行一段 Lua 脚本，逻辑分三步：</p>

<p>1）锁不存在，直接创建 Hash 结构，field 是线程标识，value 设为 1，然后设置过期时间，加锁成功</p>

<p>2）锁存在且 field 匹配当前线程，说明是重入，value 加 1，刷新过期时间，加锁成功</p>

<p>3）锁存在但 field 不匹配，说明被别人占着，返回锁的剩余存活时间，加锁失败</p>

<p>用 Hash 而不是 String 的好处是天然支持可重入，同一个线程多次加锁只需要累加计数。</p>

<p>自动续期</p>

<p>加锁成功后（不手动设置过期时间），Redisson 会启动一个后台定时任务，默认每隔 10 秒把锁的过期时间重置为 30 秒。只要业务线程还活着、还持有锁，这个续期任务就会一直跑。业务执行完调用 unlock 或者线程挂了，续期任务才停止，锁自然过期。</p>

<p>这套机制叫 Watch Dog，解决了”业务还没跑完锁就过期”的难问题。</p>

<p>解锁流程</p>

<p>解锁同样是一段 Lua 脚本：</p>

<p>1）锁不存在或者 field 不匹配当前线程，直接返回，防止误删别人的锁</p>

<p>2）field 匹配，计数减 1。如果减完还大于 0，说明还有重入没退出，刷新过期时间</p>

<p>3）计数减到 0，删除 key，同时 publish 一条消息通知其他等待的线程</p>

<h2 id="5-redis-中内存淘汰策略">5. Redis 中内存淘汰策略</h2>

<p>1、不淘汰，达到内存上限直接报错</p>

<p>2、allkeys-random 随机淘汰所有key</p>

<p>3、volatile-random 随机淘汰设置过期时间的key</p>

<p>4、volatile-ttl 优先淘汰剩余key中剩余存活时间最短的key</p>

<p>5、allkeys-lru 淘汰所有key中最近最少使用的key</p>

<p>6、allkeys-lfu 淘汰所有key中最低访问频率的key</p>

<p>7、volatile-lru 淘汰设置过期时间的key中最近最少使用的key</p>

<p>8、volatile-lfu 淘汰设置过期时间的key中最低访问频率的key</p>

<p>LRU（Least Recently Used）：最近最少使用算法</p>

<p>传统 LRU 通常通过哈希表 + 双向链表实现。每次访问一个key，就把该key移动到链表头，内存不足时，淘汰链表尾部的key。</p>

<p>Redis 使用的是近似 LRU 算法：</p>

<ol>
  <li>每个 Key 的对象元数据中保存最近访问时间信息。</li>
  <li>需要淘汰时，从候选 Key 中进行采样。</li>
  <li>根据空闲时间选择较久未访问的 Key。</li>
  <li>通过候选池优化淘汰效果。</li>
</ol>

<p>这样减少了额外的内存和维护成本，但不能保证每次淘汰的都是全局最久未访问的 Key。</p>

<p>LFU（Least Frequently Used）：最不经常使用算法</p>

<p>如果一个 Key 在一段时间内访问次数很少，那么它未来被访问的可能性也较低，因此优先淘汰它。</p>

<p>Redis 的 LFU 是根据 Key 的访问频率进行内存淘汰的，但它并不是简单地累计访问次数，而是通过概率递增和时间衰减两个机制实现。</p>

<p>首先，Redis 使用 8 位计数器保存访问频率，最大值为 255。为了让计数器能够表示更大的访问量，它使用概率递增算法。计数器越大，每次访问使计数器加 1 的概率就越低，这个过程可以通过 lfu-log-factor 参数进行调整。</p>

<p>其次，Redis 引入了时间衰减机制。因为一个 Key 过去访问频率很高，不代表它现在仍然热门。Redis 会根据距离上次记录的时间计算衰减值，默认每经过一分钟衰减一个计数单位。不过 Redis 并不会定时遍历所有 Key，而是在访问 Key 或进行淘汰采样等场景下惰性计算衰减，从而降低维护开销。</p>

<p>最后，当内存不足时，Redis 通过采样和候选池机制，优先淘汰衰减后访问频率较低的 Key。</p>

<h2 id="6-redis-中的数据过期后的删除策略">6. Redis 中的数据过期后的删除策略</h2>

<p>惰性删除和定期删除两种策略配合使用</p>

<p>惰性删除，被动触发，redis每次读写某个key之前检查该key是否过期，过期了就删掉返回空值。好处是不用占用cpu去扫描，坏处是如果一个key过期了但是一直没人访问就会一直赖在内存里；</p>

<p>定期删除，主动触发，redis每100ms触发一次定时任务，随机抽一批设置了过期时间的key进行检查，发现过期的就删掉。但是他不会一股脑的将所有key都扫描一遍而是进行有限制的采样清理，避免清理动作本身把cpu吃满。</p>

<p>定期删除的具体步骤：</p>

<p>从设置了过期时间的key集合中随机选取20个key</p>

<p>删掉其中已经过期的</p>

<p>如果已经过期的key的比例超过25%，说明还有已过期的key的概率较大，继续采样20个key</p>

<p>如果已经过期的key的比例低于25%，说明差不多了，停止定期删除的操作</p>

<p>整个定期删除过程硬性设置25ms，超时强制结束，防止主线程被卡住</p>

<h2 id="7-redis-的持久化机制">7. Redis 的持久化机制</h2>

<p>RDB 和 AOF</p>

<p>RDB 是快照持久化，某个时间点将整个redis内存数据dump成一个二进制文件。恢复速度快，文件体积小，适合做备份和灾难恢复；缺点是redis在两次快照期间宕机的话这期间的数据就丢了。</p>

<p>AOF是日志持久化，redis的每条写命令都会追加到文件中。缺点是文件体积大，恢复数据的时候会将所有命令执行一遍，数据量大的时候恢复会很慢。</p>

<p>混合持久化，在AOF重写的时候先写一份RDB快照，后面的增量部分使用AOF记录，恢复的时候先加载RDB部分，再执行AOF的增量命令。</p>

<h2 id="8-redis-的主从同步机制">8. Redis 的主从同步机制</h2>

<p>Redis 主从同步就是开启多个 Redis 实例让从节点认一个主节点当大哥，提高Redis的并发能力，实现读写分离，一般是一主多从；</p>

<p>1、建立连接与全量同步</p>

<p>当从节点第一次连接主节点时，会发送 PSYNC 命令，因为是第一次，主节点会进行全量复制，主节点生成一份RDB快照发送给从节点，从节点清空自己的旧数据加载这份快照；在主节点生成和发送RDB快照时，主节点不会停止服务，会将这段时间的增量命令暂存到Replication Buffer 的内存缓冲区中，等快照发完，再把这些增量命令发送给从节点，避免数据丢失。</p>

<p>2、命令传播</p>

<p>全量同步之后，主从之间就会建立一个长连接，主节点的新增命令都会异步的发送给从节点，从节点跟着执行相同的命令，主从之间通过心跳机制确认对方存活。</p>

<p>3、断线重连与增量同步</p>

<p>主节点内部有一个环形的缓冲区叫 repl_backlog_buffer（积压缓冲区，环形可能会形成数据覆盖）</p>

<p>从节点记录自己同步数据的offset，主节点记录自己写的新数据的offset，当从节点断线重连之后把自己的 offset 告诉主节点，主节点拿这个 offset 去 repl_backlog_buffer 里查。buffer 里每条数据都有对应的 offset 范围，能查到就增量同步，查不到说明数据被覆盖了就全量同步。</p>

<h2 id="9-redis-常见数据类型">9. Redis 常见数据类型</h2>

<p>5种：String、List、Hash、Set、Zset</p>

<h2 id="10-redis-的哨兵机制">10. Redis 的哨兵机制</h2>

<p>Redis Sentinel 是一套高可用的监控系统，专门盯着主从集群，主节点挂了能自动把从节点提升为主节点，客户端也能自动感知到新主节点的地址。</p>

<p>功能：</p>

<p>1）监控：每秒给所有 Redis 节点发 PING，看谁没响应</p>

<p>2）故障转移：主节点挂了，从从节点里选一个升级成新主节点</p>

<p>3）通知：把新主节点的地址推送给客户端和其他从节点</p>

<h2 id="11-redis-集群">11. Redis 集群</h2>

<p>Redis 集群主要解决了单机内存和并发的瓶颈，它通过多个 Redis 实例组成，每个实例存储不同的数据分片。</p>

<p>它的实现原理，可以用三个关键词来概括：分片、Gossip 协议、去中心化。</p>

<p>1）数据怎么存的？</p>

<p>Redis 集群引入了哈希槽的概念，把整个数据集群划分为 16384 个槽。集群里的每个主节点负责维护一部分槽。</p>

<p>存一个 Key 时，Redis 先对 Key 算一个 CRC16 值，然后对 16384 取模，算出它属于哪个槽，再把数据存到负责这个槽的节点上。</p>

<p>这样做的好处是扩容缩容非常方便。要加一个新节点，只需要把其他节点身上的一部分槽”过户”给新节点就行了，不需要像传统哈希那样重新计算所有数据的位置。</p>

<p>2）节点之间怎么联系？</p>

<p>集群里的节点是去中心化的，没有所谓的”中心大脑”。它们之间通过 Gossip 协议互相通信。</p>

<p>每个节点定期随机选几个邻居，交换彼此的状态信息，比如”我负责哪些槽”、”我是否还活着”。这样只需要很短的时间，集群的所有节点就能达成一致，知道整个集群的拓扑结构。</p>

<p>3）客户端怎么找数据？</p>

<p>客户端可以连接集群的任意一个节点。如果客户端要找的 Key 刚好在这个节点上，那就直接返回；如果不在，这个节点不会充当代理去转发请求，而是会返回一个 MOVED 错误，告诉客户端：”这个 Key 不归我管，你去连 IP:Port 这个节点吧。”</p>

<h2 id="12-redis-中-big-key-的处理方式">12. Redis 中 Big key 的处理方式</h2>

<p>发现大key，分析业务，拆分数据，优化访问，安全删除</p>

<p>由于Redis是单线程命令，操作大key耗时较长，从而导致redis出现其他命令阻塞的问题</p>

<p>Redis 中的 “big Key” 是指一个内存空间占用比较大的键（Key），它的危害是：</p>

<p>1、内存分布不均。在集群模式下，不同 slot 分配到不同实例中，如果大 key 都映射到一个实例，则分布不均，查询效率也会受到影响。</p>

<p>2、由于 Redis 单线程执行命令，操作大 Key 时耗时较长，从而导致 Redis 出现其它命令阻塞的问题。</p>

<p>3、大 Key 对资源的占用巨大，在你进行网络 I/O 传输的时候，导致你获取过程中产生的网络流量较大，从而产生网络传输时间延长甚至网络传输发现阻塞的现象，例如一个 key 2MB，请求个 1000 次 2000 MB。</p>

<p>4、客户端超时。因为操作大 Key 时耗时较长，可能导致客户端等待超时。</p>

<p>解决 Big Key 问题可以从三个方向入手：</p>

<p>开发层面：把大对象拆成小对象，一个 Hash 100 万个 field 可以按 ID 取模拆成 100 个 Hash；对存储的数据做压缩，比如用 Snappy、LZ4 压一下再存进去；选合适的数据结构，有些用 String 存 JSON 的场景换成 Hash 能省不少内存。</p>

<p>业务层面：只存必要的数据，用户的详细地址、历史订单这些低频数据没必要全塞 Redis 里，用的时候再查数据库；从根源上避免大 Key 产生，比如评论列表只缓存前 100 条热门的。</p>

<p>架构层面：用 Redis Cluster 部署，把大 Key 拆分后散落到不同节点，响应速度能快一截。</p>

<h2 id="13-redis-中-热点-key-的处理方式">13. Redis 中 热点 key 的处理方式</h2>

<p>1、使用Caffeine实现在服务器内本地缓存，热点数据直接从 JVM 内存里读，不走网络</p>

<p>2、热点key进行拆分</p>

<p>3、通过主从复制，实现Redis的读写分离</p>

<p>4、实行限流和降级</p>

<h2 id="14-lua-脚本的功能及使用">14. Lua 脚本的功能及使用</h2>

<p>Redis 允许用户在 Redis 服务器端执行自定义的 Lua 脚本，用来实现原子操作和复杂逻辑。</p>

<p>其核心点包括：</p>

<p>原子性：Lua 脚本的所有命令在执行过程中是原子的，避免了并发修改带来的问题。</p>

<p>减少网络往返次数：通过在服务器端执行脚本，减少了客户端和服务器之间的网络往返次数，提高了性能。</p>

<p>复杂操作：可以在 Lua 脚本中执行复杂的逻辑，比如批量更新、条件更新等，超过了单个 Redis 命令的能力。</p>

<h2 id="15-redis-事务">15. Redis 事务</h2>

<p>Redis 支持事务，但它和 MySQL 事务完全是两码事。Redis 事务只保证命令打包执行不被其他客户端插队，不支持回滚。</p>

<p>Redis 事务用 MULTI、EXEC、WATCH、DISCARD 四个命令实现：</p>

<p>1、MULTI 开启事务，之后发的命令不会立即执行，而是进入一个队列排队</p>

<p>2、队列里可以塞任意多条命令，Redis 会回复 QUEUED 表示入队成功</p>

<p>3、EXEC 一次性把队列里的命令全部执行，期间不会被其他客户端的命令打断</p>

<p>4、如果中途不想执行了，用 DISCARD 丢弃整个队列</p>

<p>5、WATCH 可以在 MULTI 之前监视某些 key，如果这些 key 在 EXEC 之前被别人改了，整个事务作废</p>

<p>最重要的一点：MySQL 事务执行到一半出错可以回滚，Redis 不行。Redis 事务里某条命令执行失败，剩下的命令照样继续跑，已经执行的也不会撤销。</p>

<h2 id="16-redis-io多路复用">16. Redis I/O多路复用</h2>

<p>Redis 的 I/O 多路复用（I/O Multiplexing） 是 Redis 实现高并发的重要技术之一。</p>

<p>I/O 多路复用就是让一个线程同时监听多个客户端的网络连接，当某个连接有数据可读或可写时，再去处理对应的 I/O 事件，而不是为每个客户端创建一个线程。</p>

<p>它主要解决的问题是：如何使用少量线程，高效处理大量客户端的网络连接。</p>]]></content><author><name>Xudu</name></author><category term="八股文" /><summary type="html"><![CDATA[时不时打个补丁，让自己的知识体系少点漏洞。]]></summary></entry><entry><title type="html">Tmux 使用教程</title><link href="https://xuduyinuo.cn/tmux-tutorial/" rel="alternate" type="text/html" title="Tmux 使用教程" /><published>2026-04-10T22:52:48+08:00</published><updated>2026-04-10T22:52:48+08:00</updated><id>https://xuduyinuo.cn/tmux-tutorial</id><content type="html" xml:base="https://xuduyinuo.cn/tmux-tutorial/"><![CDATA[<p>tmux（Terminal Multiplexer）是一个终端复用工具，它允许你在单个终端窗口中创建多个虚拟终端会话，并能保持这些会话在后台运行。</p>

<!-- more -->

<p>与直接使用终端相比，tmux 提供了更强大的会话管理功能。</p>

<h2 id="安装tmux">安装Tmux</h2>

<div class="language-shell highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c"># Ubuntu/Debian</span>
<span class="nb">sudo </span>apt-get <span class="nb">install </span>tmux

<span class="c"># CentOS/RHEL</span>
<span class="nb">sudo </span>yum <span class="nb">install </span>tmux

<span class="c"># macOS (使用 Homebrew)</span>
brew <span class="nb">install </span>tmux
</code></pre></div></div>

<h2 id="理解-tmux-的三层关系">理解 Tmux 的三层关系</h2>

<ol>
  <li><strong>会话</strong>：一个独立的后台工作区。你关掉终端窗口，里面的程序<strong>继续运行</strong>。</li>
  <li><strong>窗口</strong>：会话里的不同标签页，相当于浏览器里打开了多个网页。</li>
  <li><strong>窗格</strong>：一个窗口内分割出来的小屏幕，方便你同时看日志、写代码、跑命令。</li>
</ol>

<p>示例：</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>会话: 我的项目A
  ├── 窗口1: 代码编辑器
  │     ├── 窗格1: Vim 写代码
  │     └── 窗格2: 运行测试脚本
  └── 窗口2: 系统监控
        └── 窗格1: htop 看性能
</code></pre></div></div>

<h2 id="tmux-快捷键">Tmux 快捷键</h2>

<p>Tmux 的所有命令都需要先按一个<strong>前缀键</strong>来唤醒，系统才知道你在命令 Tmux，而不是在打字。</p>

<p>默认前缀键：Ctrl + b</p>

<h3 id="1-会话管理">1. 会话管理</h3>

<table>
  <thead>
    <tr>
      <th style="text-align: left">操作</th>
      <th style="text-align: left">快捷键 / 命令</th>
      <th style="text-align: left">说明</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">新建会话</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">tmux new -s 名字</code></td>
      <td style="text-align: left">给会话起个名，方便找回</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>脱离会话</strong></td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">Ctrl + b + d</code></td>
      <td style="text-align: left"><strong>程序后台运行，窗口随便关</strong></td>
    </tr>
    <tr>
      <td style="text-align: left">查看会话列表</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">tmux ls</code></td>
      <td style="text-align: left">终端里直接敲，不用进 Tmux</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>重新接入</strong></td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">tmux attach -t 名字</code></td>
      <td style="text-align: left"><strong>回到刚才的工作现场</strong></td>
    </tr>
  </tbody>
</table>

<div class="language-shell highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c"># 杀死会话</span>
<span class="c"># 使用会话编号</span>
<span class="nv">$ </span>tmux kill-session <span class="nt">-t</span> 0

<span class="c"># 使用会话名称</span>
<span class="nv">$ </span>tmux kill-session <span class="nt">-t</span> &lt;session-name&gt;
</code></pre></div></div>

<h3 id="2-窗口管理">2. 窗口管理</h3>

<table>
  <thead>
    <tr>
      <th style="text-align: left">操作</th>
      <th style="text-align: left">快捷键</th>
      <th style="text-align: left">记忆技巧</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>新建窗口</strong></td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">Ctrl + b + c</code></td>
      <td style="text-align: left"><strong>C</strong>reate</td>
    </tr>
    <tr>
      <td style="text-align: left">切换下一个窗口</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">Ctrl + b + n</code></td>
      <td style="text-align: left"><strong>N</strong>ext</td>
    </tr>
    <tr>
      <td style="text-align: left">切换上一个窗口</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">Ctrl + b + p</code></td>
      <td style="text-align: left"><strong>P</strong>revious</td>
    </tr>
    <tr>
      <td style="text-align: left">显示窗口列表</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">Ctrl + b + w</code></td>
      <td style="text-align: left"><strong>W</strong>indows（可视化选择）</td>
    </tr>
    <tr>
      <td style="text-align: left">关闭当前窗口</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">exit</code> 或 <code class="language-plaintext highlighter-rouge">Ctrl + d</code></td>
      <td style="text-align: left">窗格/窗口内没有程序就关了</td>
    </tr>
  </tbody>
</table>

<h3 id="3-窗格管理">3. 窗格管理</h3>

<table>
  <thead>
    <tr>
      <th style="text-align: left">操作</th>
      <th style="text-align: left">快捷键</th>
      <th style="text-align: left">记忆技巧</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>左右分屏</strong></td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">Ctrl + b + %</code></td>
      <td style="text-align: left">像一个<strong>百分比</strong>竖线 <code class="language-plaintext highlighter-rouge">|</code></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>上下分屏</strong></td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">Ctrl + b + "</code></td>
      <td style="text-align: left">像一个<strong>双引号</strong>横线 <code class="language-plaintext highlighter-rouge">—</code></td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>切换光标</strong></td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">Ctrl + b + 方向键</code></td>
      <td style="text-align: left">上下左右移动焦点</td>
    </tr>
    <tr>
      <td style="text-align: left">关闭当前窗格</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">exit</code> 或 <code class="language-plaintext highlighter-rouge">Ctrl + d</code></td>
      <td style="text-align: left"> </td>
    </tr>
    <tr>
      <td style="text-align: left">最大化/还原窗格</td>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">Ctrl + b + z</code></td>
      <td style="text-align: left"><strong>Z</strong>oom，再按一次还原</td>
    </tr>
  </tbody>
</table>

<h2 id="tmux-配置文件">Tmux 配置文件</h2>

<div class="language-shell highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c"># 编辑配置文件，设置 Tmux 一直支持鼠标操作</span>
vim ~/.tmux.conf

<span class="c"># 在配置文件中添加以下配置</span>
<span class="nb">set</span> <span class="nt">-g</span> mouse on
</code></pre></div></div>

<p>在已经打开的Tmux会话中需要输入以下命令才会生效，之后打开的Tmux会话自动生效</p>

<div class="language-shell highlighter-rouge"><div class="highlight"><pre class="highlight"><code>1. 按 Ctrl+b :
2. 在底部出现的命令栏中输入source-file ~/.tmux.conf，然后按回车即可
</code></pre></div></div>

<p>怎么配置mac使用终端连接远程服务器，在终端中使用tmux怎么复制tmux中的信息到本机的剪切板中</p>

<p>因为mac自带的终端不支持OSC 52协议，所以在该教程中使用Clipper工具进行复制tmux会话中的内容至本机剪切板</p>

<p>原理：</p>

<p>Clipper在本机 Mac 上作为后台服务运行，把<strong>本机剪切板</strong>通过 socket 暴露出来；在远程服务器里的 tmux/vim 把内容写到这个 socket，经 SSH 的 <code class="language-plaintext highlighter-rouge">RemoteForward</code> 转回本机，最后进入 Mac 剪切板。</p>

<p>安装并启动Clipper</p>

<div class="language-shell highlighter-rouge"><div class="highlight"><pre class="highlight"><code>brew <span class="nb">install </span>clipper

brew services start clipper
</code></pre></div></div>

<p>配置本机ssh转发 （配置文件~/.ssh/config）</p>

<div class="language-shell highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Host myserver<span class="o">(</span>取一个唯一的名字，后续通过ssh连接时只需要输入该名字即可，不用输入ip地址<span class="o">)</span>
  HostName 你的服务器IP或域名
  User 你的用户名
  RemoteForward 8377 localhost:8377（clipper默认监听端口是8377）
</code></pre></div></div>

<p>配置远程服务器的tmux配置文件（~/.tmux.conf）</p>

<div class="language-shell highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nb">set</span> <span class="nt">-g</span> mouse on
setw <span class="nt">-g</span> mode-keys vi

<span class="nb">bind</span> <span class="nt">-T</span> copy-mode-vi v send <span class="nt">-X</span> begin-selection
<span class="nb">bind</span> <span class="nt">-T</span> copy-mode-vi y send <span class="nt">-X</span> copy-pipe-and-cancel <span class="s2">"nc -N localhost 8377"</span>
<span class="nb">bind</span> <span class="nt">-T</span> copy-mode-vi Enter send <span class="nt">-X</span> copy-pipe-and-cancel <span class="s2">"nc -N localhost 8377"</span>
</code></pre></div></div>]]></content><author><name>Xudu</name></author><category term="教程" /><category term="tmux" /><category term="tutorial" /><summary type="html"><![CDATA[Tmux 一个终端复用工具~]]></summary></entry><entry><title type="html">LogicRAG：无需预构建图的自适应检索增强生成</title><link href="https://xuduyinuo.cn/LogicRAG/" rel="alternate" type="text/html" title="LogicRAG：无需预构建图的自适应检索增强生成" /><published>2026-03-17T21:55:06+08:00</published><updated>2026-03-17T21:55:06+08:00</updated><id>https://xuduyinuo.cn/LogicRAG</id><content type="html" xml:base="https://xuduyinuo.cn/LogicRAG/"><![CDATA[<p>通过动态构建子问题依赖图，让检索与推理按逻辑顺序展开。这篇笔记梳理 LogicRAG 如何应对复杂问答，并通过上下文摘要与图剪枝控制检索成本。
<!-- more --></p>

<h2 id="论文信息">论文信息</h2>

<p>Title：<strong>You Don’t Need Pre-built Graphs for RAG: Retrieval Augmented Generation with Adaptive Reasoning Structures</strong></p>

<p>Source：AAAI 2026</p>

<p>Code：https://github.com/chensyCN/LogicRAG</p>

<h2 id="背景">背景</h2>

<p>LLM在处理超出参数知识问题时，常常会产生幻觉，产生事实上不正确的陈述。RAG 通过从语料库中检索查询相关上下文来支持LLM推理，从而解决了这一问题。</p>

<p>但是，传统 RAG 在简单问答中效果不错，但在<strong>复杂问答、多跳推理</strong>任务中会遇到明显困难：</p>

<p>1、相关信息分散在多个文档中</p>

<p>2、不是一次检索就能拿到完整证据</p>

<p>3、不同证据之间存在逻辑依赖，不能简单拼接</p>

<p>2024年，微软提出了GraphRAG：先把整个语料库构造成图，再在图上进行检索和推理</p>

<p>这种基于图的检索方式在复杂任务中表现出显著的性能。</p>

<p>现有GraphRAG方法的不足</p>

<p>1、离线建图代价高：需要提前处理整个知识库，消耗大量时间和 token。</p>

<p>2、图质量不稳定：自动建图可能引入错误边、冗余连接，影响后续检索。</p>

<p>3、静态图不够灵活：知识库图是预先建好的，但真实问题的推理路径是动态的，静态图未必适配当前问题。</p>

<h2 id="创新点">创新点</h2>

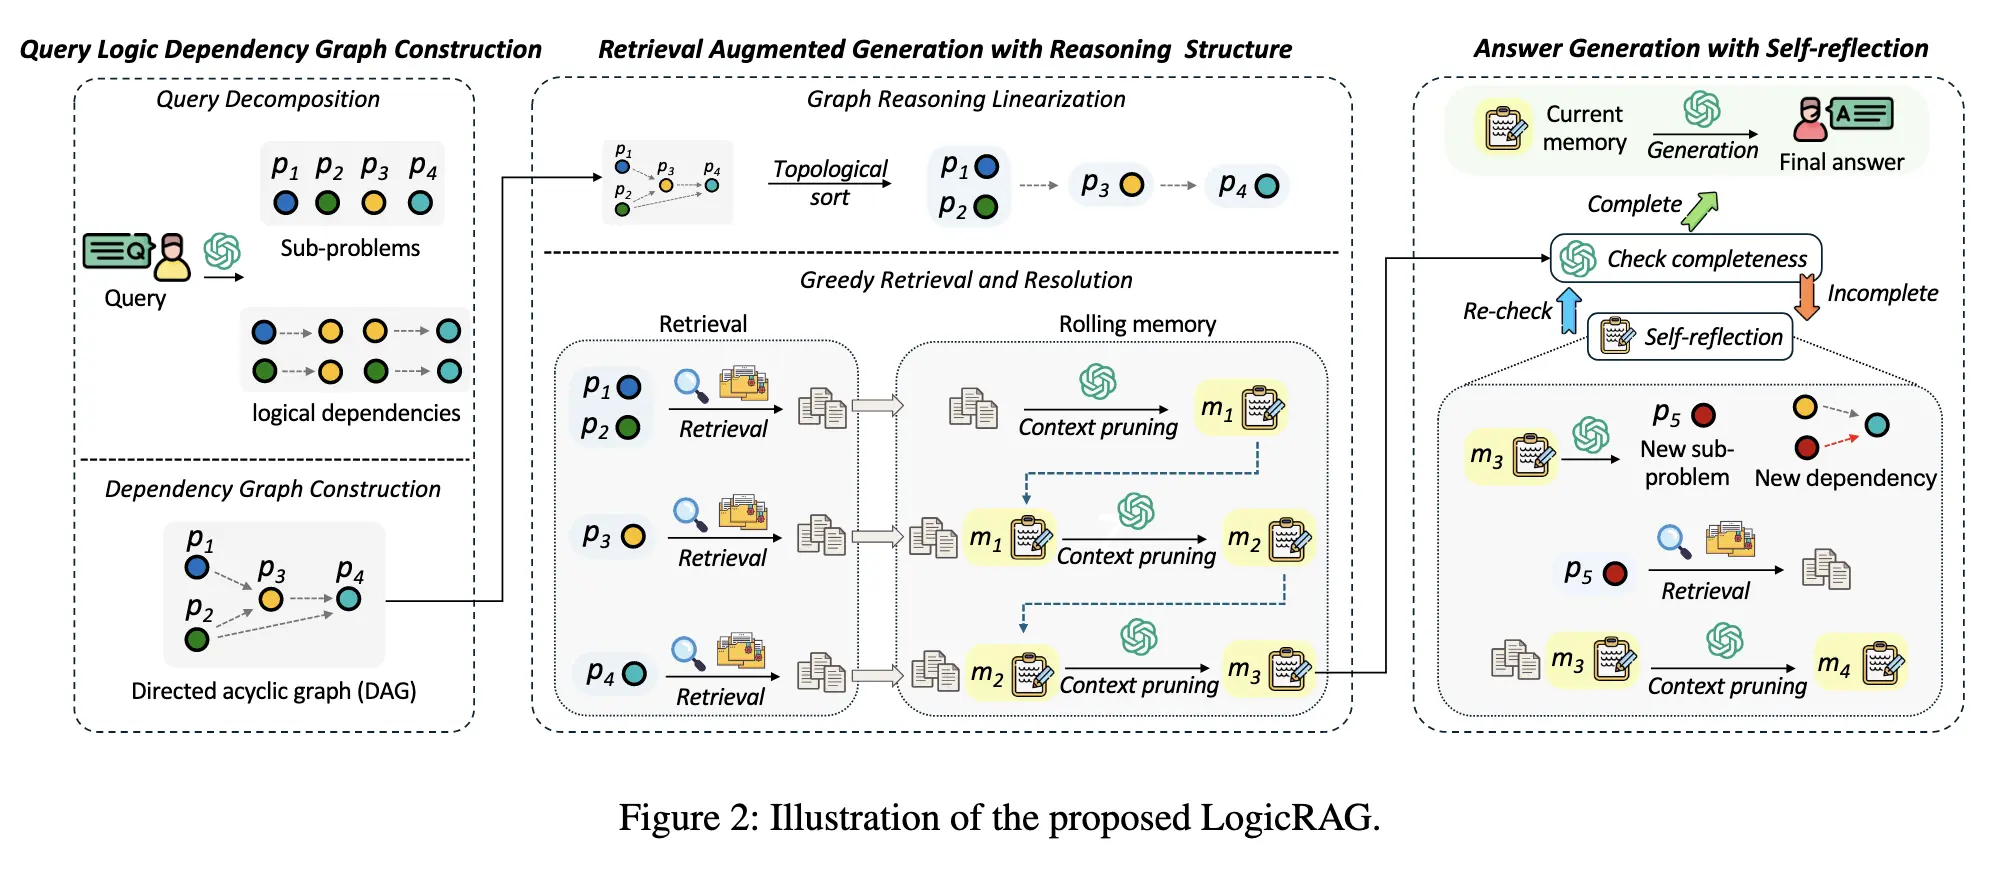
<p>论文提出了一种逻辑感知的检索增强生成框架（LogicRAG），该框架在推理时动态提取推理结构，无需预先构建图即可指导自适应检索。</p>

<p>1、分析了现有GraphRAG局限性，提出了一种在推理时动态提取推理结构的新框架LogicRAG，用于指导自适应检索。</p>

<p>2、用有向无环图对查询逻辑依赖关系进行建模，提供了一种有原则的、通用的推理结构建模方法。</p>

<p>3、使用拓扑排序将图推理线性化、引入上下文总结摘要和图剪枝来实现高效的推理。（关键机制）</p>

<h2 id="方法论">方法论</h2>

<p><img src="../images/LogicRAG/logicRAG%E6%A1%86%E6%9E%B6%E5%9B%BE.webp" alt="logicRAG框架图" /></p>

<p>1、问题分解：给定复杂问题 Q，先用 LLM 将其拆成若干子问题</p>

<p>2、构建查询逻辑依赖图：把每个子问题作为图中的一个节点，由 LLM 判断依赖关系，构建一个有向无环图</p>

<p>3、拓扑排序：将图推理线性化，得到一个合理的求解顺序</p>

<p>4、检索与求解：用“当前子问题 + 已有父节点答案”进行检索；根据检索结果回答当前子问题。（上下文摘要总结和图剪枝）</p>

<p>Rolling Memory滚动记忆：Mem(i)=Summarize(Mem(i−1)∪R(p(i)))</p>

<p>取旧记忆，加上当前检索结果，用 LLM 做一次摘要融合，得到新的记忆</p>

<p>图剪枝：同一 拓扑排序 的子问题有时可以合并。合并成统一查询，得到共享上下文再分别解答子问题</p>

<p>5、自我反思与动态扩展：如果系统发现当前图还不够完整、信息还不足，就触发反思，新增子问题，补充依赖边，继续推理</p>

<h2 id="实验分析">实验分析</h2>

<p>1、三个数据集：HotpotQA、2WikiMQA、MuSiQue</p>

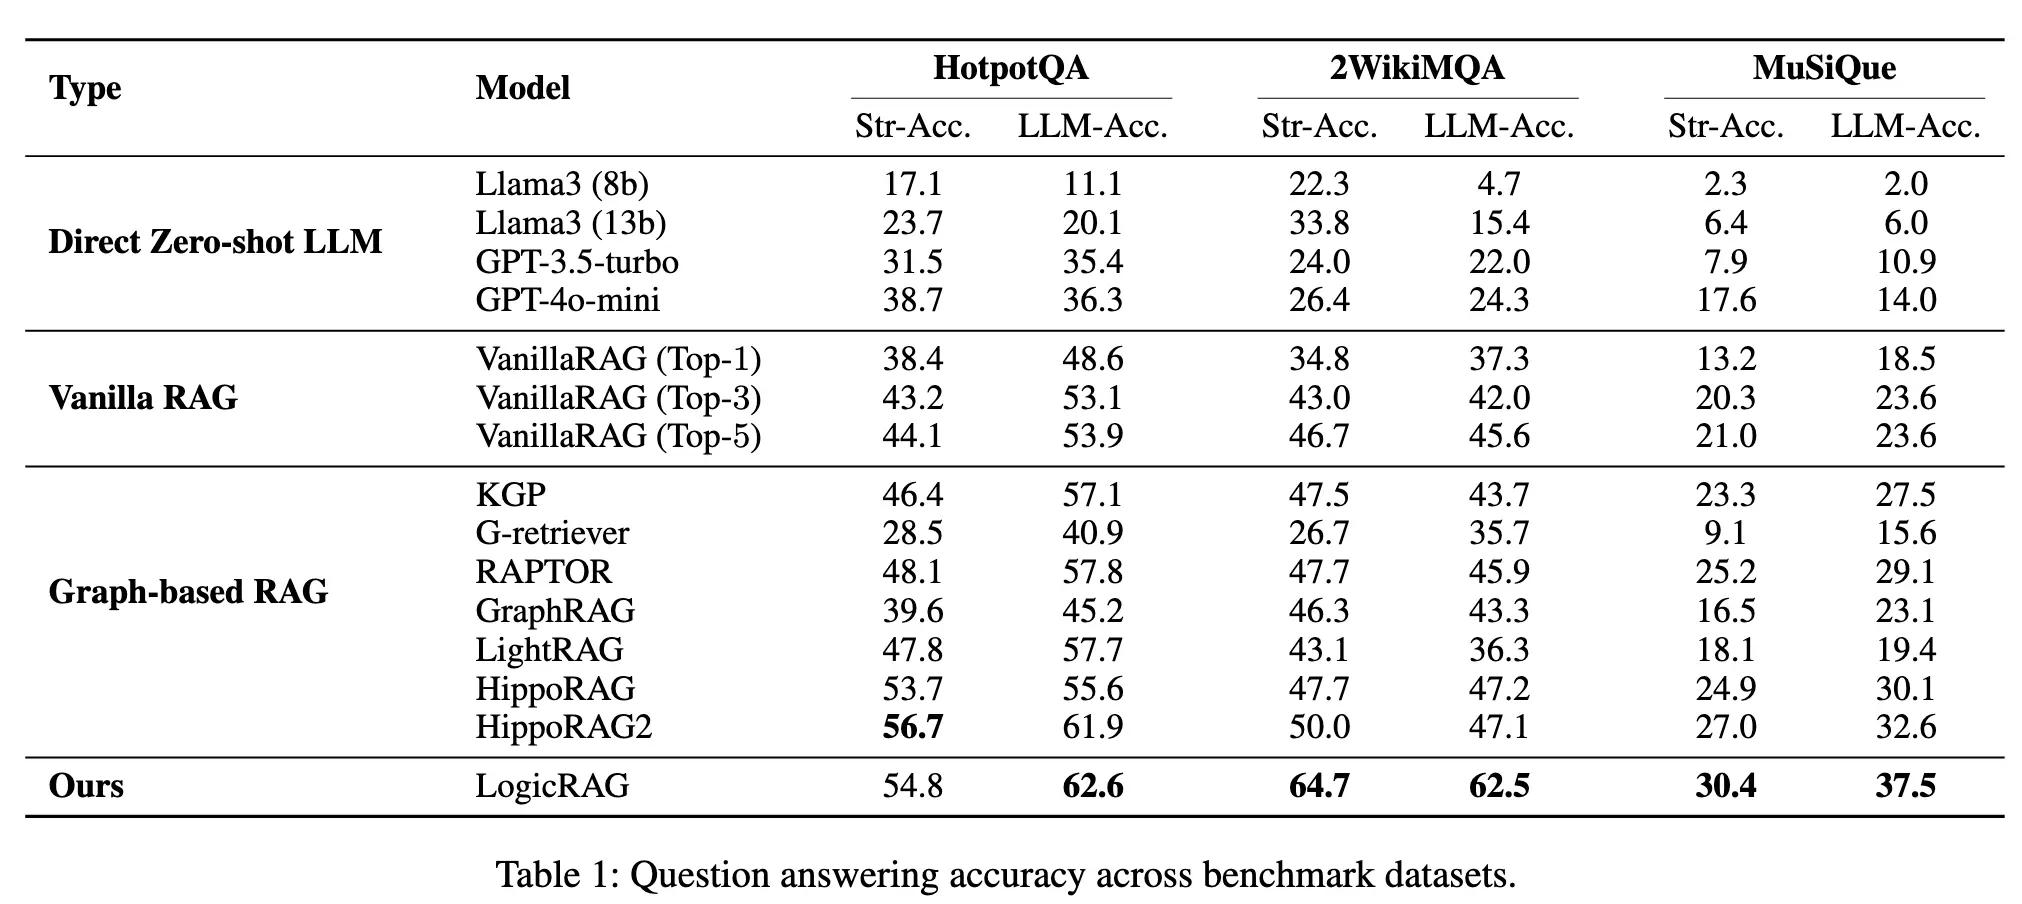
<p>2、对比实验结果</p>

<p><img src="../images/LogicRAG/result.webp" alt="result" /></p>

<p>LogicRAG 整体优于 Vanilla RAG，也优于多种 GraphRAG 基线</p>

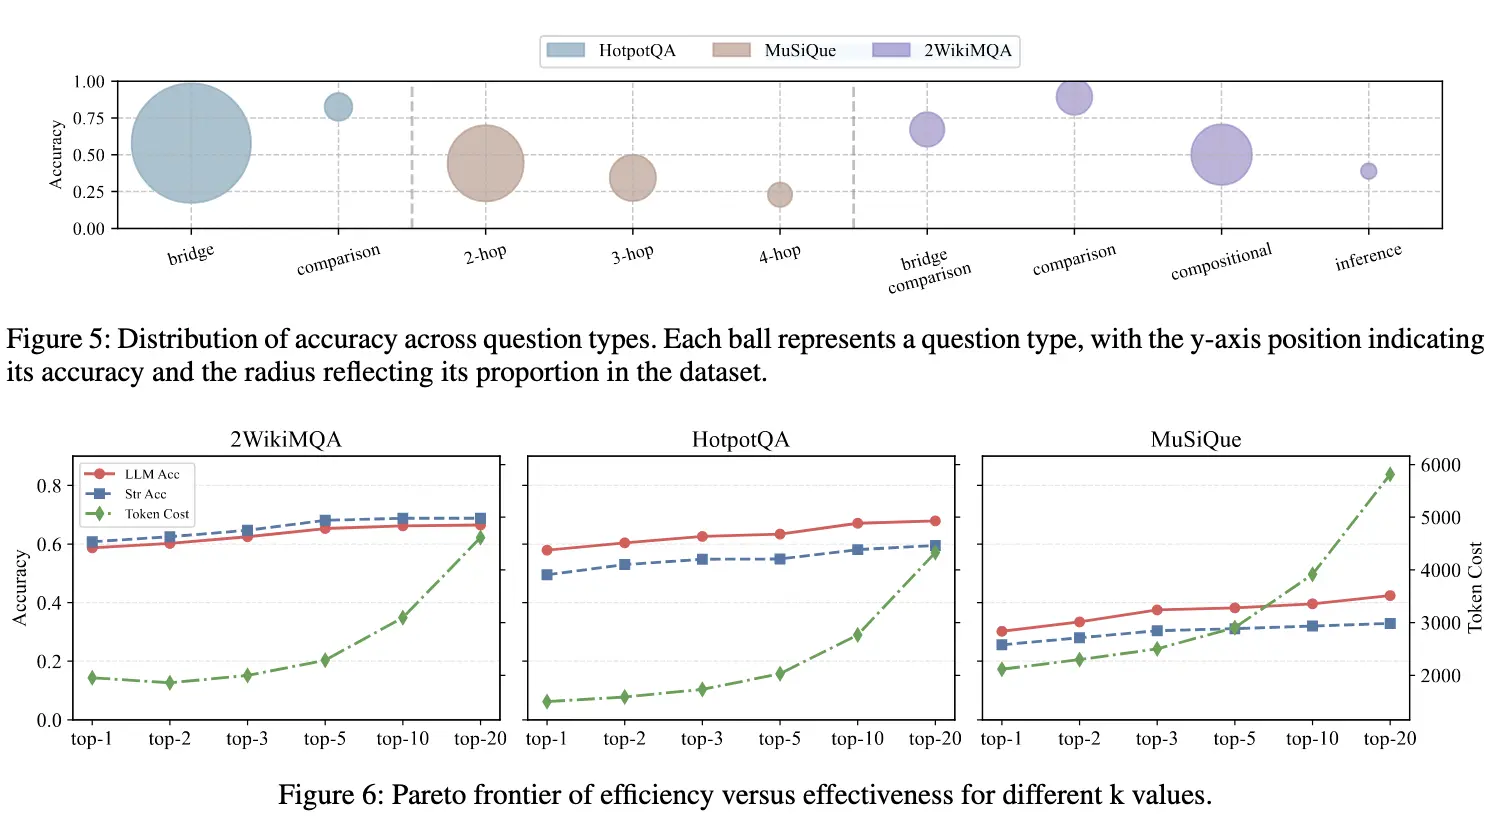
<p>3、效率与成本分析</p>

<p><img src="../images/LogicRAG/exp2.webp" alt="实验" /></p>

<p>图5：不同类型的问题上的准确率和数据分布结果</p>

<p>图6：top-k 检索 对准确率和token成本的影响</p>

<p>检索更多，效果会提升，但提升效果逐渐变小，token成本也会提升的快</p>

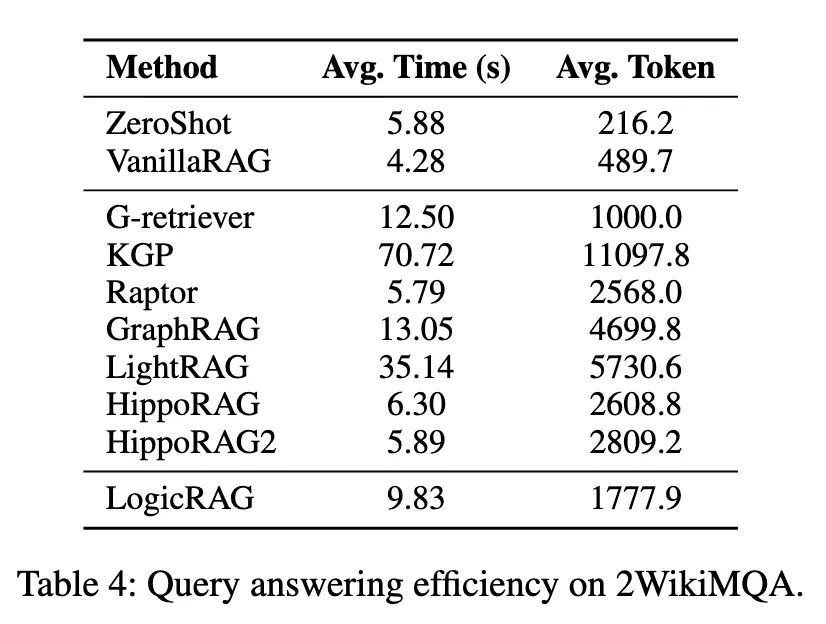
<p>4、时间效率结果</p>

<p><img src="../images/LogicRAG/%E6%97%B6%E9%97%B4%E6%95%88%E7%8E%87.webp" alt="时间效率" style="zoom:50%;" /></p>

<p>平均时间：9.83  平均token：1777.9</p>

<p>时间不是最优，但是 <strong>token 成本控制较好</strong></p>

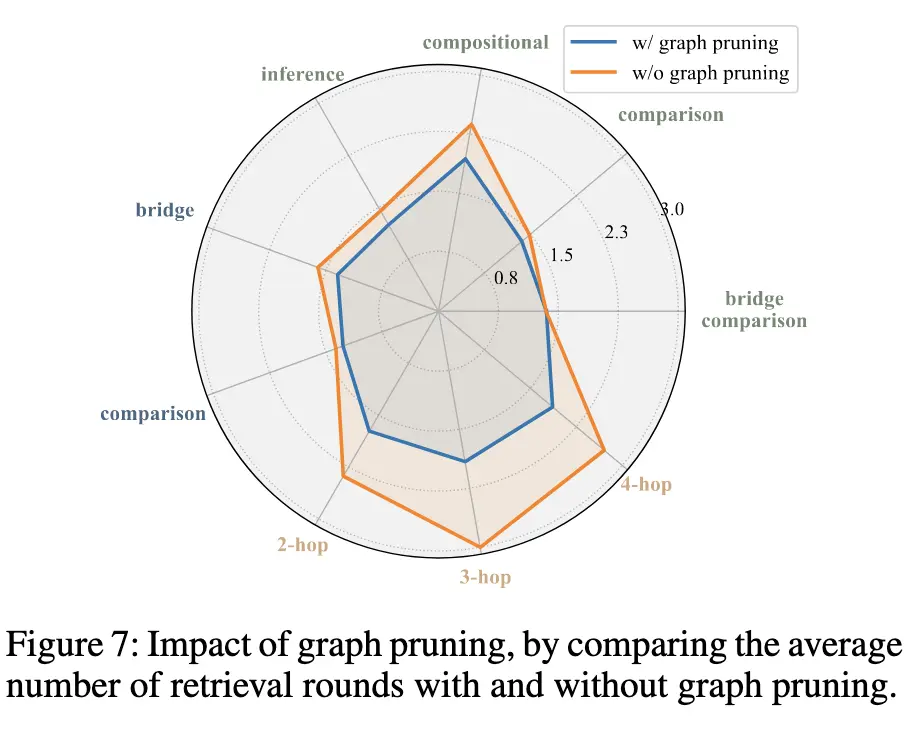
<p>5、图剪枝的有效性验证</p>

<p><img src="../images/LogicRAG/fig7.webp" alt="fig7" style="zoom:50%;" /></p>

<p>加入 图剪枝 之后，各类问题的平均检索轮数都下降了。说明图剪枝确实减少了冗余子问题带来的重复检索。</p>

<h2 id="总结">总结</h2>

<p>LogicRAG 把 GraphRAG 从知识库层面转移到问题推理层面。通过动态构建子问题依赖图，让检索和推理按逻辑顺序展开，同时通过 上下文摘要总结 和 图剪枝 控制成本。相比传统静态 GraphRAG，它更灵活、更贴合复杂问答。</p>]]></content><author><name>Xudu</name></author><category term="论文笔记" /><category term="RAG" /><category term="GraphRAG" /><summary type="html"><![CDATA[通过动态构建子问题依赖图，让检索与推理按逻辑顺序展开。这篇笔记梳理 LogicRAG 如何应对复杂问答，并通过上下文摘要与图剪枝控制检索成本。]]></summary></entry><entry><title type="html">开始是结束的开始？愿我们都能成为生活的高手！</title><link href="https://xuduyinuo.cn/we-made-beautiful-bouquet/" rel="alternate" type="text/html" title="开始是结束的开始？愿我们都能成为生活的高手！" /><published>2026-01-15T20:31:26+08:00</published><updated>2026-01-15T20:31:26+08:00</updated><id>https://xuduyinuo.cn/we-made-beautiful-bouquet</id><content type="html" xml:base="https://xuduyinuo.cn/we-made-beautiful-bouquet/"><![CDATA[<p>有着诸多相同的兴趣爱好的恋人</p>

<p>最后却以遗憾结束……</p>

<!-- more -->

<p><img src="../images/we-made-beautiful-bouquet/00.webp" alt="00" /></p>

<h2 id="邂逅同频">邂逅、同频</h2>

<p>山音麦、八谷绢</p>

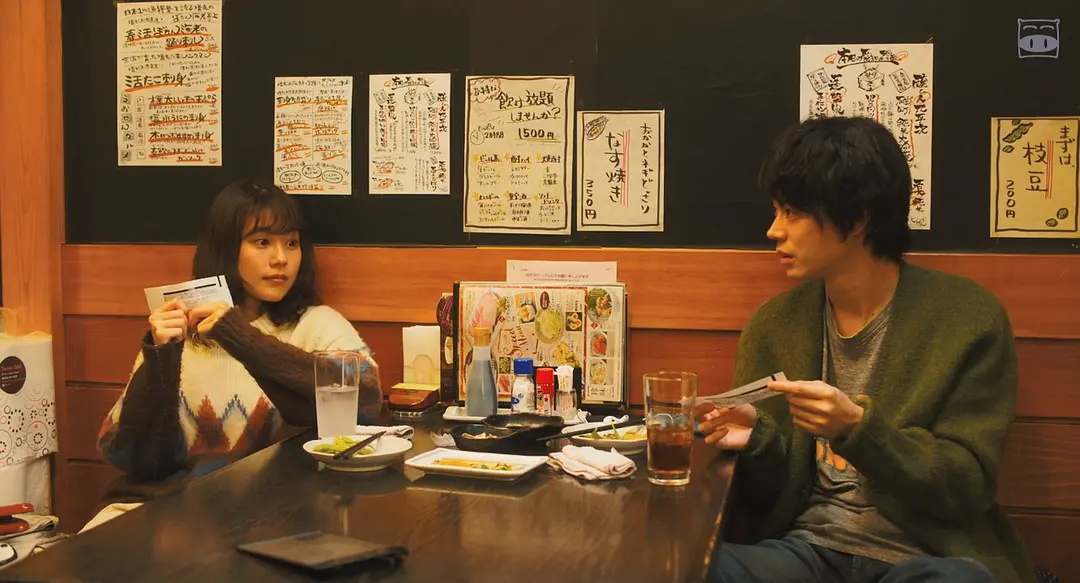
<p>两个错过末班地铁的大学生意外发现两人的兴趣爱好出奇的一致</p>

<p>两人都喜欢相同的电影、音乐和文学作品</p>

<p>都喜欢用电影票当书签</p>

<p>都好奇石头剪刀布的规则，为什么布能赢石头？明明石头能将布戳个洞</p>

<p>还都一起错过了同一个喜剧专场</p>

<p>在几次交谈中</p>

<p>两人互生好感</p>

<p>渐生情愫</p>

<p><img src="../images/we-made-beautiful-bouquet/01.webp" alt="01" /></p>

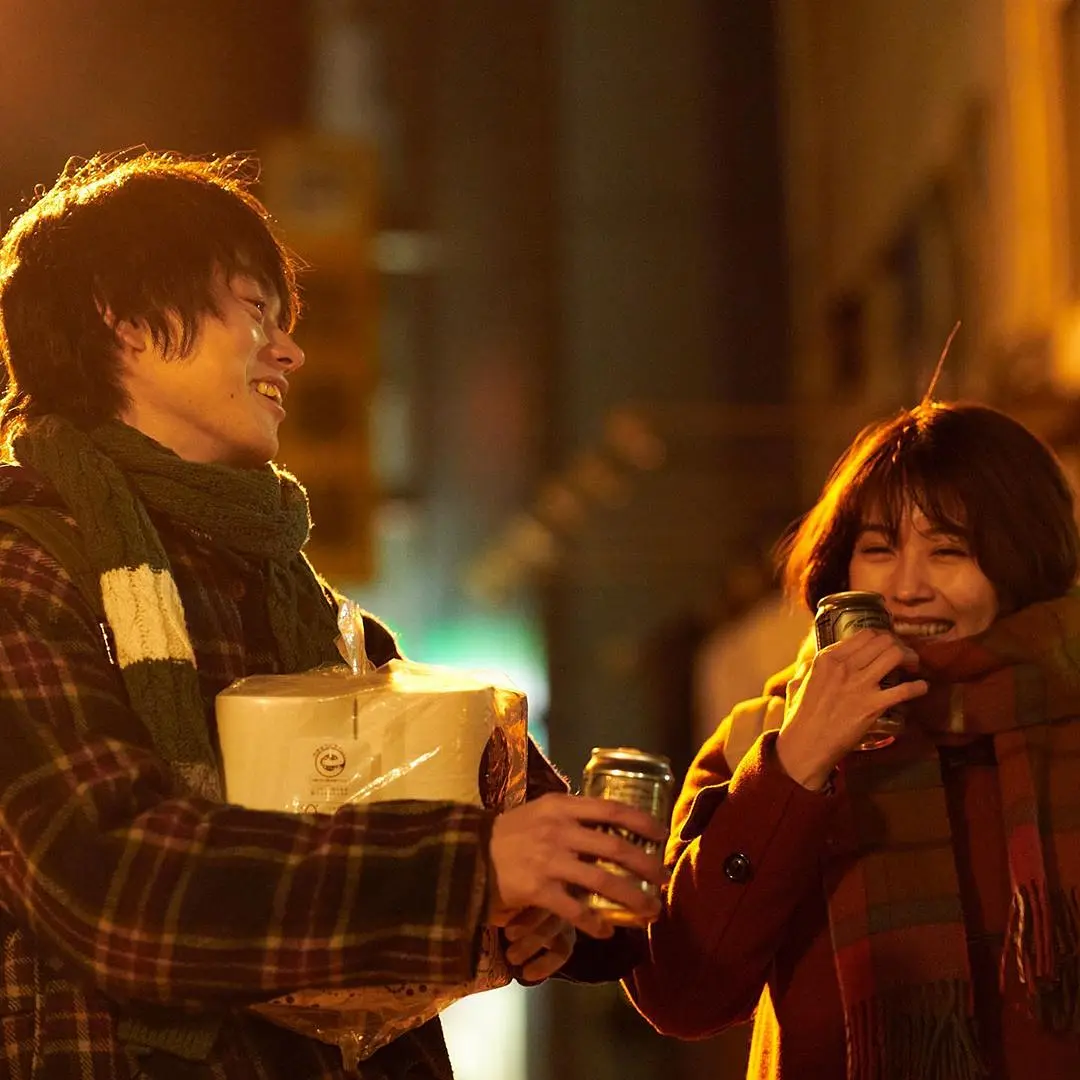
<h2 id="热恋纯粹">热恋、纯粹</h2>

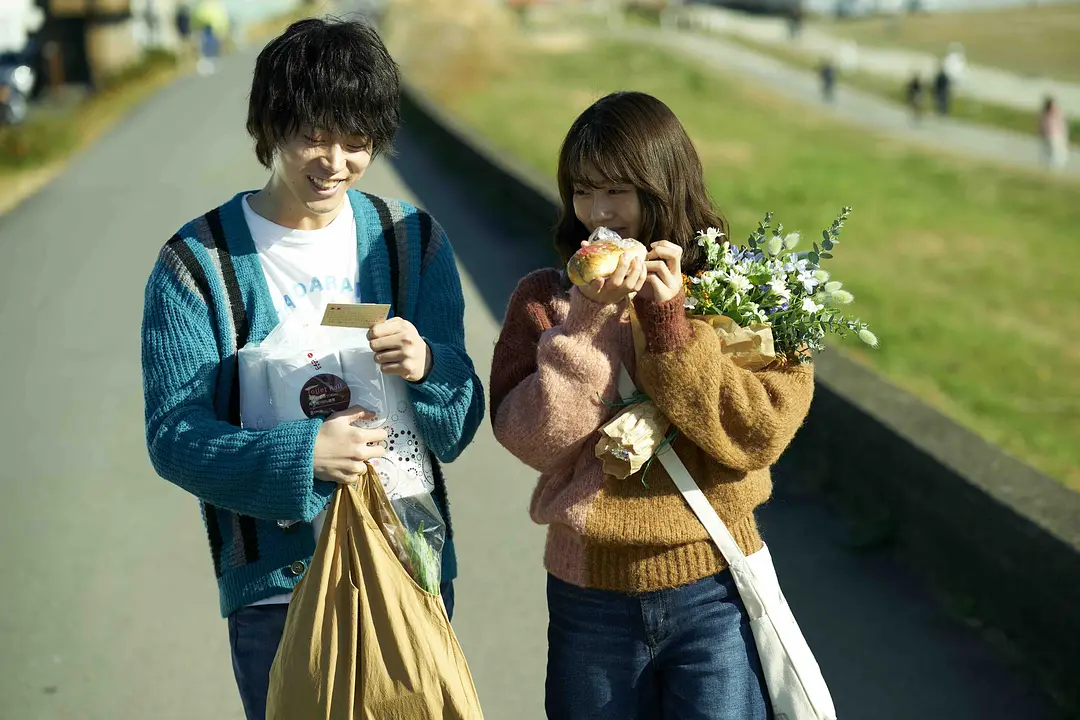
<p>毕业，同居</p>

<p>两人在多摩川河畔的出租屋过着惬意的日子</p>

<p>麦以兼职插画赚钱</p>

<p>绢在冰淇淋店兼职</p>

<p>领养黑猫男爵</p>

<p>去老夫妇的面包房买喜欢的面包</p>

<p>下班后回家的三十分钟散步时间</p>

<p>是两人最温馨的记忆</p>

<p>阳台上，麦对绢说</p>

<p>我的人生目标就是，一直跟你过现在这样的生活。</p>

<p><img src="../images/we-made-beautiful-bouquet/02.webp" alt="02" /></p>

<h2 id="现实错位">现实、错位</h2>

<p>没有坚实的物质基础的保障下</p>

<p>理想的乌托邦式的恋爱生活不能长久</p>

<p>一张插画由一千日元降到三张插画一千日元（约44RMB）</p>

<p>麦不得不开始找工作</p>

<p>绢考上了会计师证</p>

<p>先找到了一份朝九晚五的工作</p>

<p>随后几经面试</p>

<p>麦也入职一家初创物流公司</p>

<p>由此开始</p>

<p>生活、工作、理想不能同时兼顾</p>

<p>绢在下班后可以看书、打游戏，维持喜好</p>

<p>麦却不得不频繁加班，作策划</p>

<p>两人都想照顾对方的感受</p>

<p>但慢慢出现分歧</p>

<p>两双不同鞋子的特写</p>

<p>后备箱中扔掉的书籍</p>

<p>都表明两人不再同频</p>

<p>刚开始的两人只是想过好普通生活</p>

<p>最后发现并不容易</p>

<p><img src="../images/we-made-beautiful-bouquet/03.webp" alt="03" /></p>

<h2 id="终焉释然">终焉、释然</h2>

<p>在朋友的婚礼上</p>

<p>两人向各自的好友袒露心声</p>

<p>现在的爱情和完全不同于刚开始的模样</p>

<p>重回告白的地点</p>

<p>看见一对情侣</p>

<p>和当初的自己一样</p>

<p>热烈、纯真、充满可能</p>

<p>又想到当初的甜蜜和当下的遗憾</p>

<p>两人相拥落泪</p>

<p>决定分手</p>

<p><img src="../images/we-made-beautiful-bouquet/04.webp" alt="04" /></p>

<p>电影好似绝大多数情侣的真实写照</p>

<p>从百分百合拍到长时间消耗和平分手</p>

<p>本质还是没有物质保障</p>

<p>为了更好的生活</p>

<p>必须要放弃一部分</p>

<p>麦的理想主义最终被工作的琐碎磨灭</p>

<p>作为旁观者而言</p>

<p>多希望他能平衡好工作和生活</p>

<p>想了想，即使两人衣食无忧</p>

<p>可能也有其他插曲来干扰正常的生活节奏</p>

<p><img src="../images/we-made-beautiful-bouquet/05.webp" alt="05" /></p>

<p>我们普通人所能借鉴的</p>

<p>只是经营好自己的生活</p>

<p>借用房客中乐瑶的名言</p>

<p>希望我们每个人，都能做生活的高手</p>]]></content><author><name>Xudu</name></author><category term="电影" /><category term="花束般的恋爱" /><category term="有村架纯" /><category term="电影" /><summary type="html"><![CDATA[花束般的恋爱]]></summary></entry><entry><title type="html">MySQL中如何执行一条select语句？</title><link href="https://xuduyinuo.cn/sql-statement-guide/" rel="alternate" type="text/html" title="MySQL中如何执行一条select语句？" /><published>2026-01-04T16:04:27+08:00</published><updated>2026-01-04T16:04:27+08:00</updated><id>https://xuduyinuo.cn/sql-statement-guide</id><content type="html" xml:base="https://xuduyinuo.cn/sql-statement-guide/"><![CDATA[<p>由一条select语句的执行流程，了解MySQL的内部结构！</p>

<!-- more -->

<h2 id="mysql架构">MySQL架构</h2>

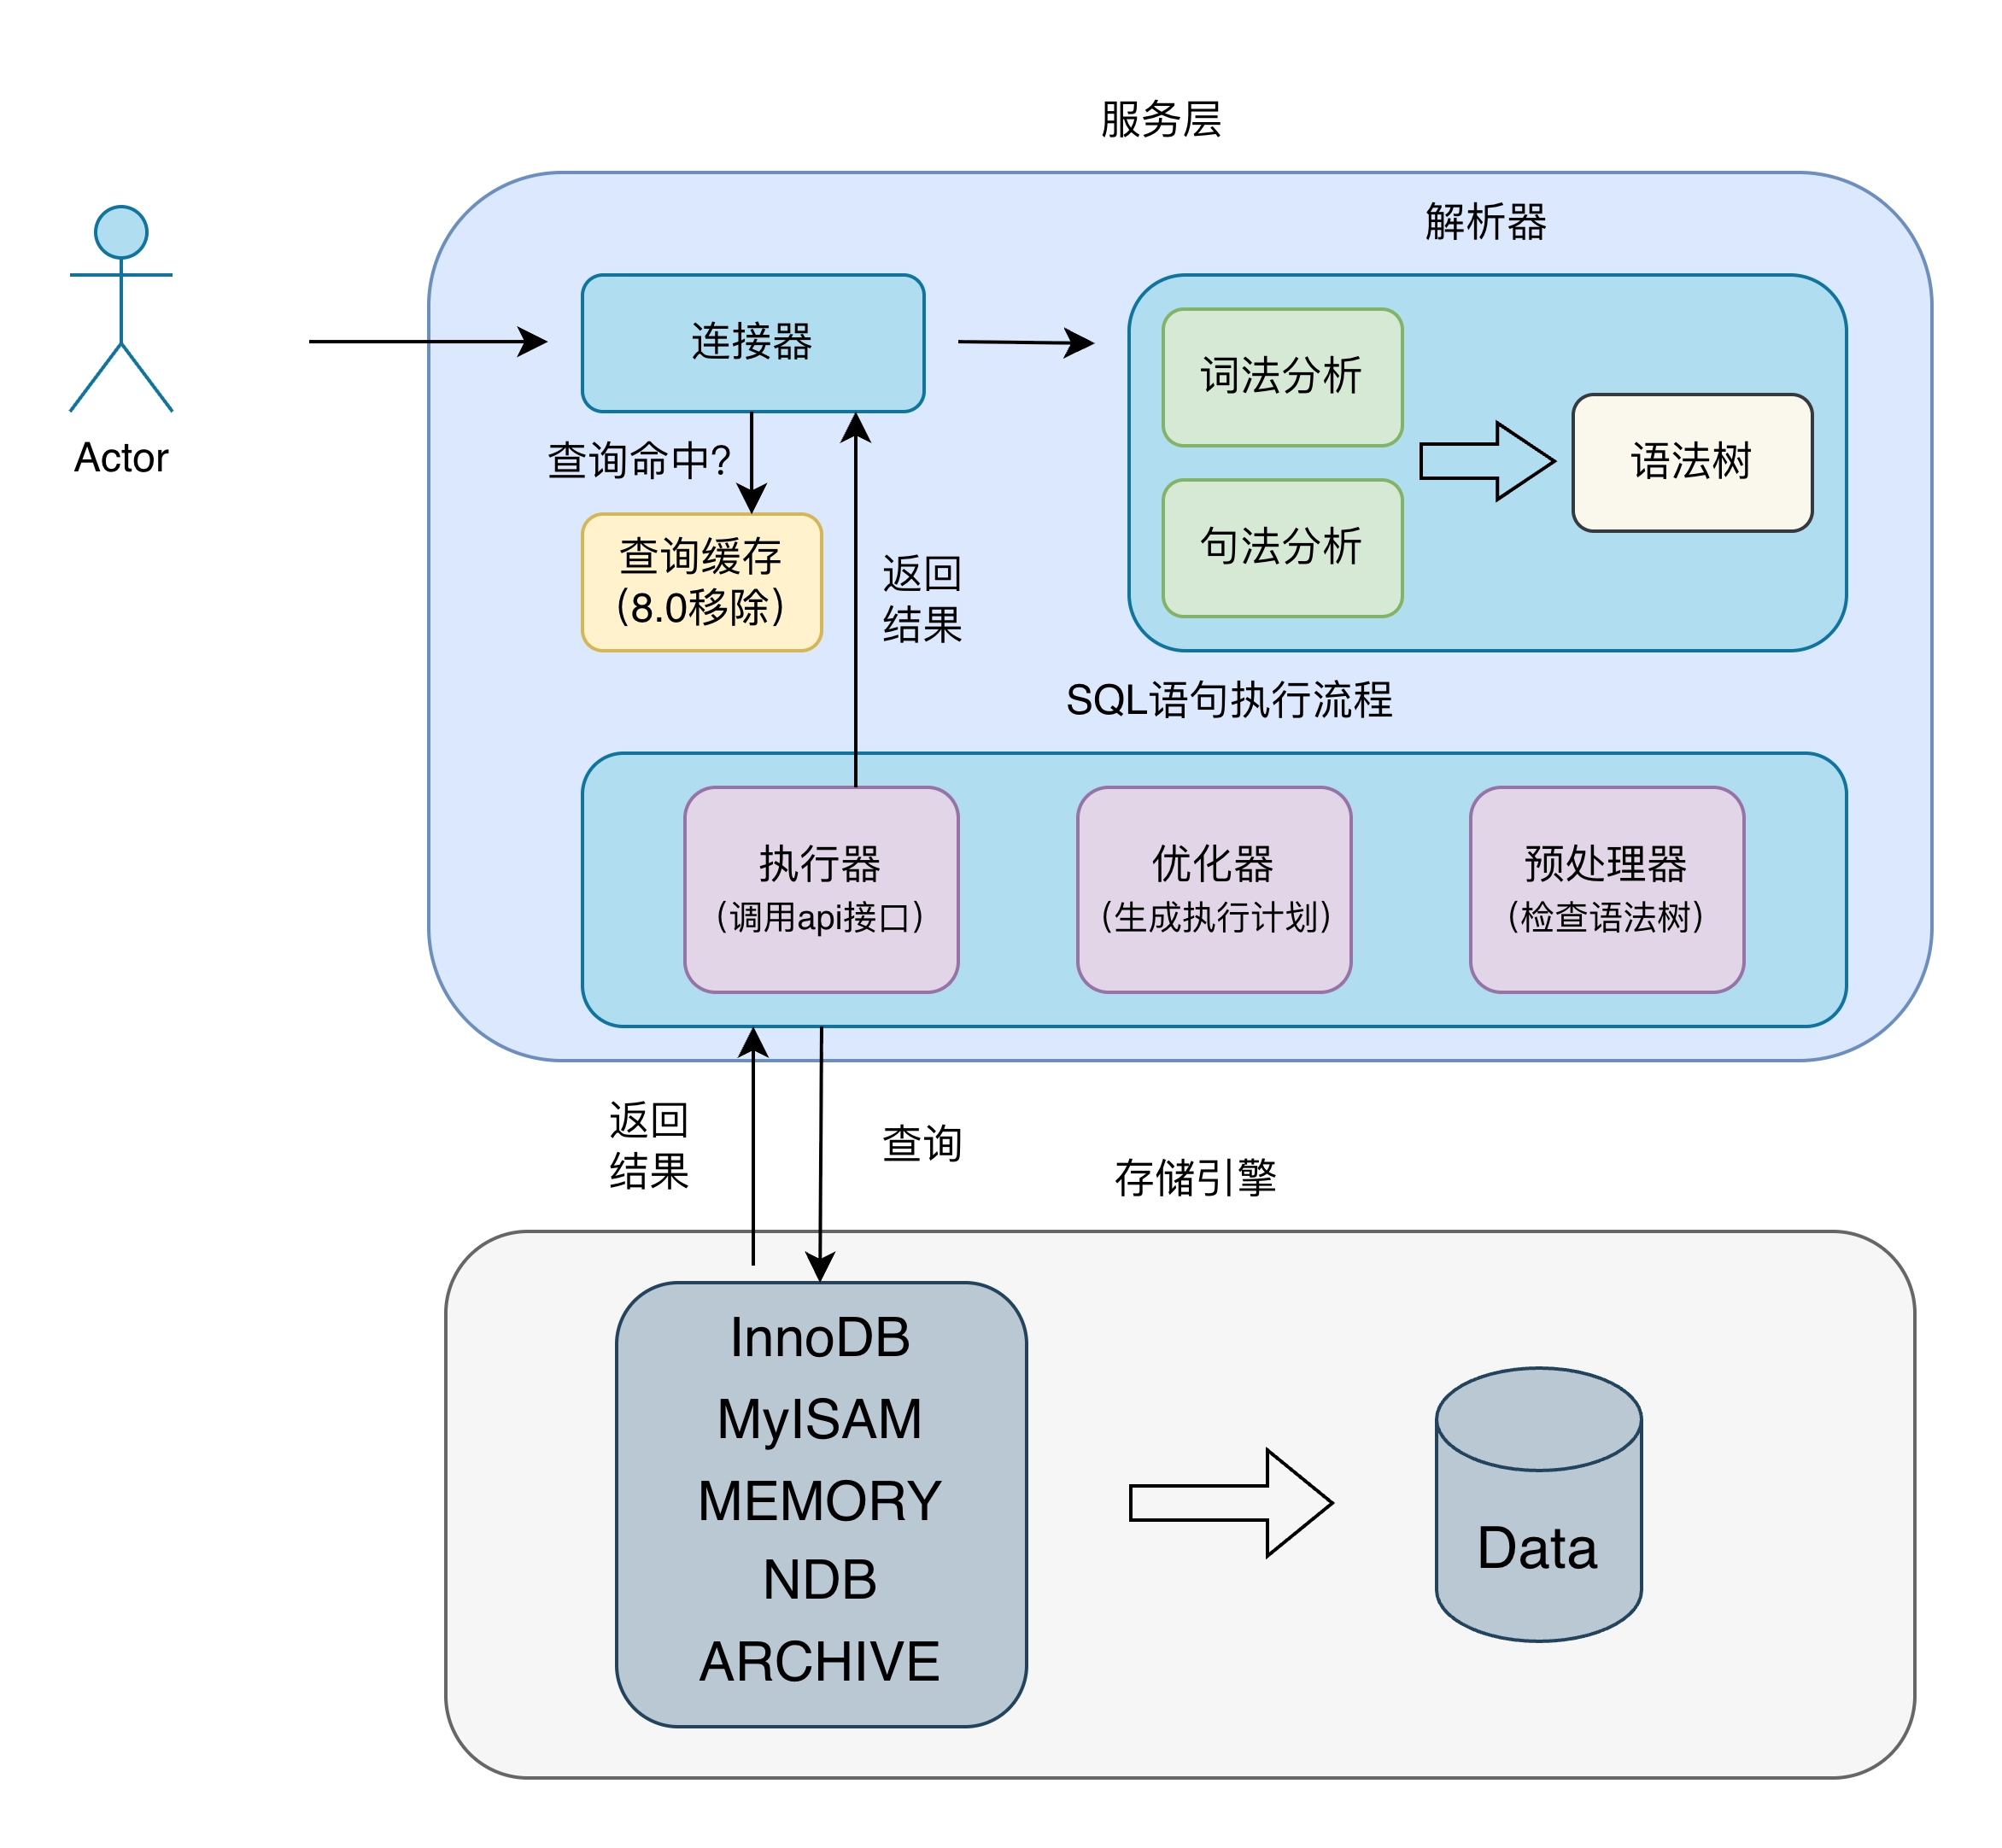
<p>下图是MySQL的整体架构，主要分为两层，Server层和存储引擎。</p>

<p><img src="../images/sql-statement-guide/20260104095558721.webp" alt="MySQL架构图" style="zoom: 25%;" /></p>

<p>Server层：负责建立连接、分析和执行 SQL</p>

<p>包含核心功能模块：连接器、查询缓存（8.0版本移除）、解析器、预处理器、优化器、执行器、内置函数（如日期、时间、数学和加密函数等）和所有跨存储引擎的功能（存储过程、触发器、视图）。</p>

<p>存储引擎：负责数据的存储和提取</p>

<p>支持多种存储引擎，不同存储引擎共用同一个Server层，默认存储引擎为InnoDB。</p>

<h2 id="连接器">连接器</h2>

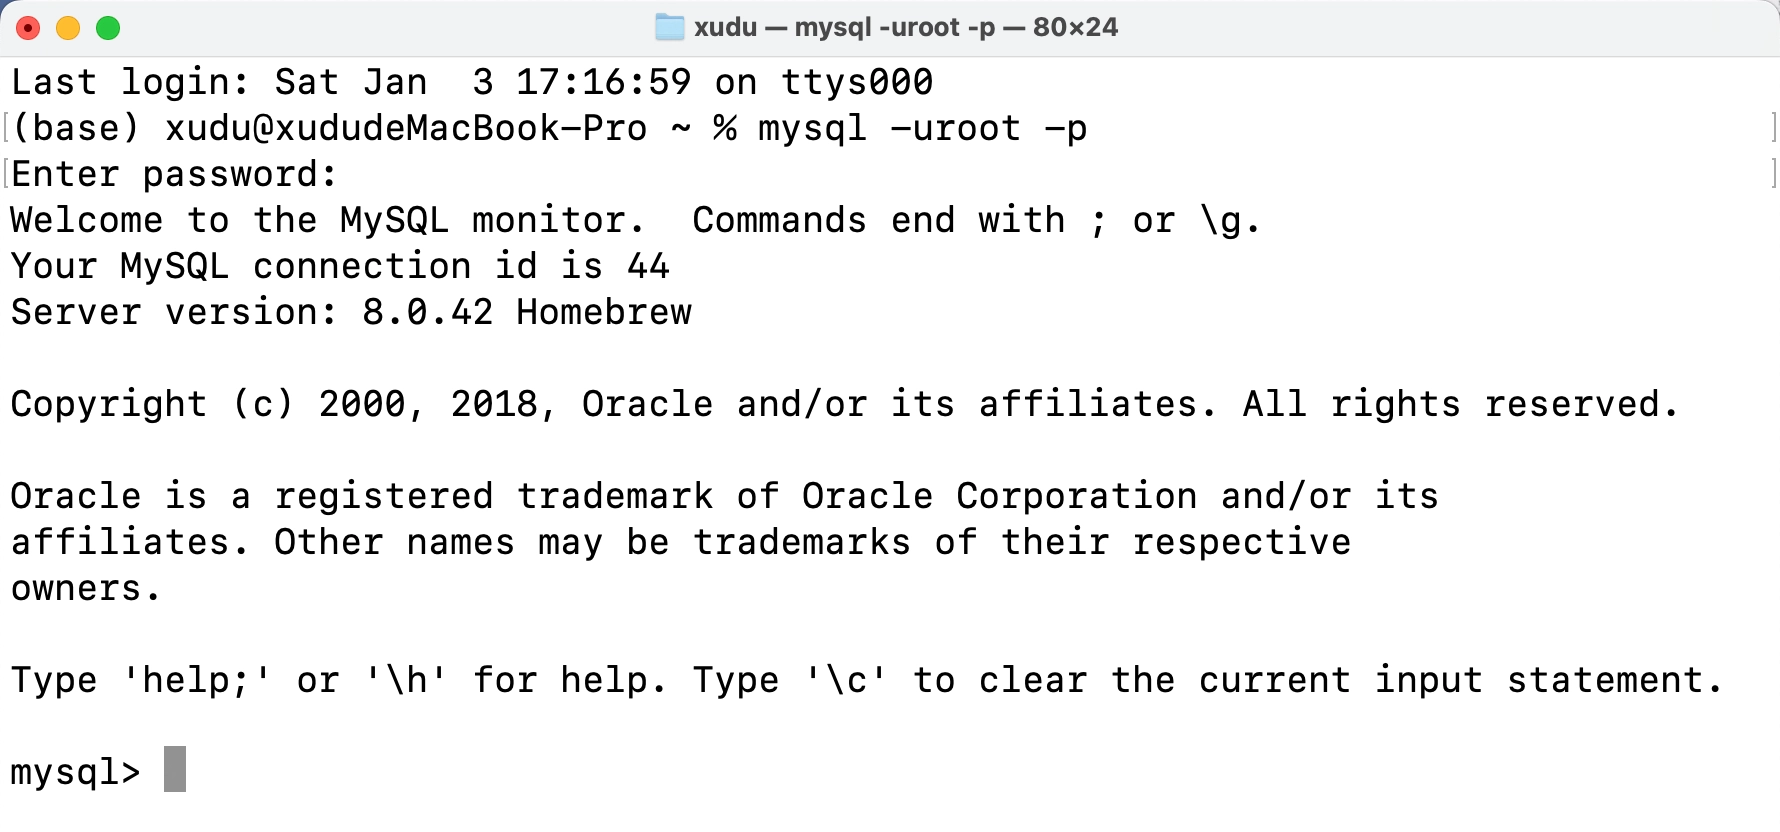
<p>使用MySQL之前需要先进行连接（登录）MySQL服务，然后才能执行SQL语句，连接语句如下：</p>

<div class="language-sql highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="o">#</span> <span class="o">-</span><span class="n">h</span> <span class="err">指定</span> <span class="n">MySQL</span> <span class="err">服务得</span> <span class="n">IP</span> <span class="err">地址，如果是连接本地的</span> <span class="n">MySQL</span><span class="err">服务，可以不用这个参数；</span>
<span class="o">#</span> <span class="o">-</span><span class="n">u</span> <span class="err">指定用户名，管理员角色名为</span> <span class="n">root</span><span class="err">；</span>
<span class="o">#</span> <span class="o">-</span><span class="n">p</span> <span class="err">指定密码，如果命令行中不填写密码（为了密码安全，建议不要在命令行写密码），就需要在交互对话里面输入密码</span>
<span class="n">mysql</span> <span class="o">-</span><span class="n">h</span><span class="err">$</span><span class="n">ip</span> <span class="o">-</span><span class="n">u</span><span class="err">$</span><span class="k">user</span> <span class="o">-</span><span class="n">p</span>
</code></pre></div></div>

<p>连接过程需要经过TCP三次握手，连接之前确保启动MySQL服务，使用正确的用户名和密码，连接成功如下</p>

<p><img src="../images/sql-statement-guide/20260104102100681.webp" alt="image-20260104102048666" style="zoom:50%;" /></p>

<p>连接成功后连接器就会获取该用户的权限，然后保存起来，后续该用户在此连接里的任何操作，都会基于连接开始时读到的权限进行权限逻辑的判断。所以，如果一个用户已经建立了连接，即使管理员中途修改了该用户的权限，也不会影响已经存在连接的权限。修改完成后，只有再新建的连接才会使用新的权限设置。</p>

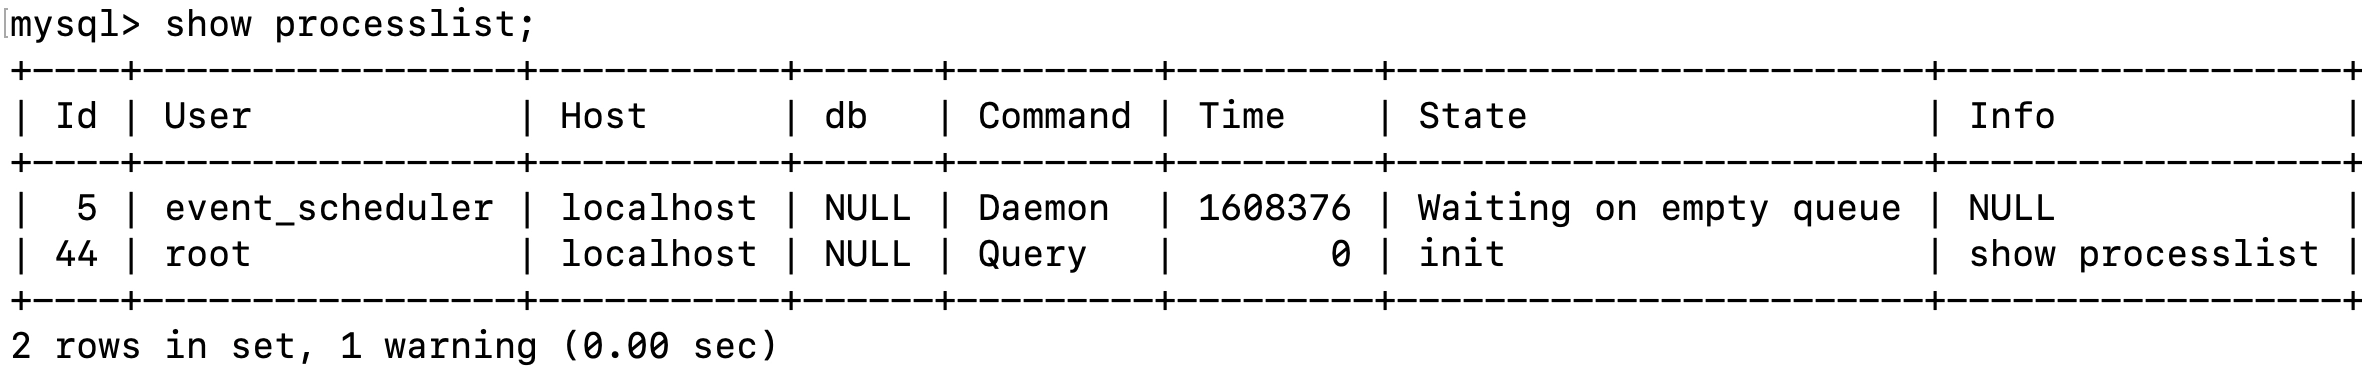
<p>查看当前MySQL服务被多少个客户端连接：show processlist</p>

<p><img src="../images/sql-statement-guide/20260104103235296.webp" alt="image-20260104103233284" /></p>

<p>空闲连接</p>

<p>MySQL 定义了空闲连接的最大空闲时长，由 wait_timeout 参数控制的，默认值是 8 小时（28880秒），如果空闲连接超过了这个时间，连接器就会自动将它断开。</p>

<p>使用的是 kill connection + id 命令手动断开空闲连接。</p>

<p>MySQL 的连接数限制</p>

<p>MySQL 服务支持的最大连接数由 max_connections 参数控制，默认是 151 。</p>

<p>短连接和长连接</p>

<div class="language-sql highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="o">//</span> <span class="err">短连接</span>
<span class="err">连接</span> <span class="n">mysql</span> <span class="err">服务（</span><span class="n">TCP</span> <span class="err">三次握手）</span>
<span class="err">执行</span><span class="k">sql</span>
<span class="err">断开</span> <span class="n">mysql</span> <span class="err">服务（</span><span class="n">TCP</span> <span class="err">四次挥手）</span>

<span class="o">//</span> <span class="err">长连接</span>
<span class="err">连接</span> <span class="n">mysql</span> <span class="err">服务（</span><span class="n">TCP</span> <span class="err">三次握手）</span>
<span class="err">执行</span><span class="k">sql</span>
<span class="p">....</span>
<span class="err">断开</span> <span class="n">mysql</span> <span class="err">服务（</span><span class="n">TCP</span> <span class="err">四次挥手）</span>
</code></pre></div></div>

<p>长连接可以减少建立连接和断开连接的过程，所以一般是推荐使用长连接</p>

<p>长连接后可能会占用内存增多，因为 MySQL 在执行查询过程中临时使用内存管理连接对象，这些连接对象资源只有在连接断开时才会释放。如果长连接累计很多，将导致 MySQL 服务占用内存太大，有可能会被系统强制杀掉，这样会发生 MySQL 服务异常重启的现象。</p>

<p>总结连接器流程：</p>

<p>1、与客户端进行 TCP 三次握手建立连接；</p>

<p>2、校验客户端的用户名和密码，如果用户名或密码不对，则会报错；</p>

<p>3、如果用户名和密码都对了，会读取该用户的权限，然后后面的权限逻辑判断都基于此时读取到的权限；</p>

<h2 id="查询缓存">查询缓存</h2>

<p>连接器得工作完成后，客户端就可以向 MySQL 服务发送 SQL 语句了，MySQL 服务收到 SQL 语句后，就会解析出 SQL 语句的第一个字段，看看是什么类型的语句。</p>

<p>在8.0之前的版本中，如果SQL是select语句，MySQL会先进行查询缓存，如果命中则直接返回，未命中则继续执行。</p>

<p>对于更新比较频繁的表，查询缓存的命中率很低的，因为只要一个表有更新操作，那么这个表的查询缓存就会被清空。</p>

<h2 id="解析器">解析器</h2>

<p>在正式执行 SQL 查询语句之前， MySQL 会先对 SQL 语句做解析。</p>

<p>词法分析：</p>

<p>把字符串切成 token，MySQL 会根据你输入的字符串识别出关键字</p>

<p>语法分析：</p>

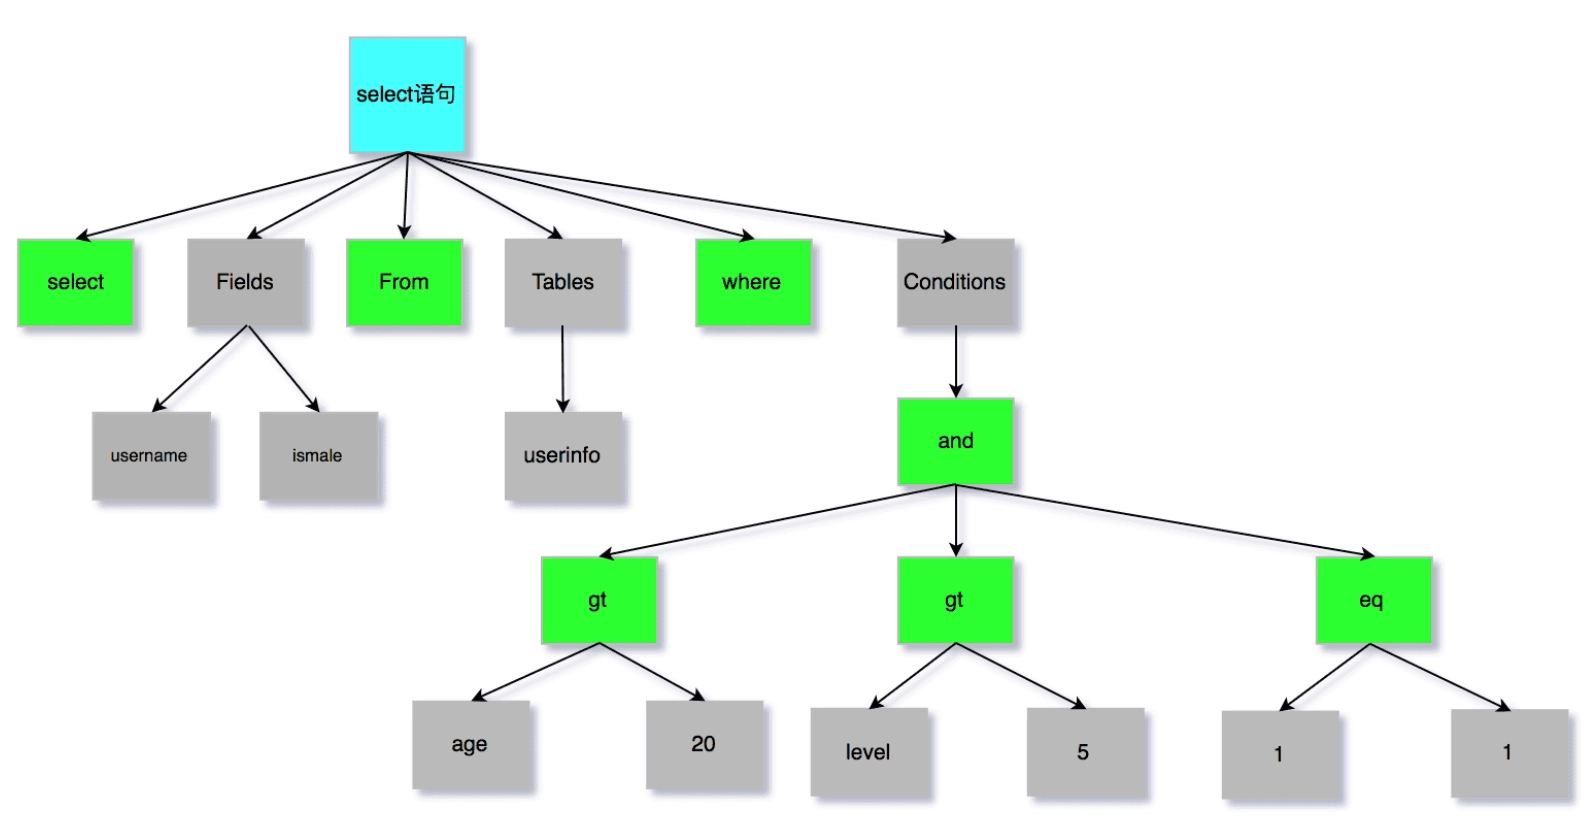
<p>根据词法分析的结果，语法解析器会根据语法规则，判断你输入的这个 SQL 语句是否满足 MySQL 语法，如果没问题就会构建出 SQL 语法树，这样方便后面模块获取 SQL 类型、表名、字段名、 where 条件等等。</p>

<p><img src="../images/sql-statement-guide/20260104155413190.webp" alt="image-20260104155407094" style="zoom:50%;" /></p>

<h2 id="执行sql流程">执行SQL流程</h2>

<h3 id="预处理器">预处理器</h3>

<p>检查 SQL 查询语句中的表或者字段是否存在；</p>

<p>将 <code class="language-plaintext highlighter-rouge">select *</code> 中的 <code class="language-plaintext highlighter-rouge">*</code> 符号，扩展为表上的所有列；</p>

<p>预处理器负责把解析器产出的语法结构“落到真实的库表对象上”，让一条语句从“语法正确”变成“语义可执行”。它会解析并确认语句里引用的库、表、列等对象是否存在且可访问（比如表不存在会在这一阶段直接报错），同时会把 <code class="language-plaintext highlighter-rouge">select *</code> 这类模糊表达展开成明确的列清单，必要时也会完成与权限、类型相关的基础校验。</p>

<p>它的作用是尽早发现“对象/语义层面”的问题并把查询规格化，为后续生成执行计划提供准确输入。</p>

<h3 id="优化器">优化器</h3>

<p>经过预处理阶段后，还需要为 SQL 查询语句先制定一个执行计划。</p>

<p>优化器负责为这条 SQL 选择一条成本更低的执行计划，核心就是在多种可行访问路径之间做取舍，例如决定走主键索引、二级索引还是全表扫描，以及能否利用覆盖索引来避免回表、能否使用索引下推来减少不必要的回表与记录传递等。它会基于统计信息与代价模型评估不同方案的开销，最终确定执行过程中“怎么访问数据、以什么顺序和方式取数”的策略；</p>

<p>它的作用是把同一个逻辑查询变成尽可能高效的物理执行方案，<code class="language-plaintext highlighter-rouge">EXPLAIN</code> 里看到的 key/type/Extra 等信息本质上就是优化器决策的外化结果。</p>

<h3 id="执行器">执行器</h3>

<p>经历完优化器后，就确定了执行方案，接下来 MySQL 就真正开始执行语句了，这个工作是由「执行器」完成的。在执行的过程中，执行器就会和存储引擎交互了，交互是以记录为单位的。根据执行计划执行 SQL 查询语句，从存储引擎读取记录，返回给客户端。</p>

<p>负责按优化器给定的执行计划真正把查询跑起来，并在执行过程中以记录为单位与存储引擎交互：该走索引就调用引擎的索引读取接口定位第一条或下一条记录，该全表扫就让引擎顺序返回记录，然后在 Server 层对返回的记录做条件判断与表达式计算，满足条件的就逐步发送给客户端，直到读完或满足停止条件为止。在索引下推场景下，执行器会把部分原本由 Server 层做的过滤条件交给引擎在索引层先筛掉，从而减少回表次数与数据搬运。它的作用是把“计划”转化为具体的读、判、发动作，协调 Server 层与存储引擎完成整条语句的实际执行。</p>

<p>三种方式：</p>

<p>主键索引查询</p>

<div class="language-sql highlighter-rouge"><div class="highlight"><pre class="highlight"><code> <span class="k">select</span> <span class="o">*</span> <span class="k">from</span> <span class="n">product</span> <span class="k">where</span> <span class="n">id</span> <span class="o">=</span> <span class="mi">1</span><span class="p">;</span>
</code></pre></div></div>

<p>以上面的SQL语句为例，这条查询语句的查询条件用到了主键索引，而且是等值查询，同时主键 id 是唯一，不会有 id 相同的记录，所以优化器决定选用访问类型为 const 进行查询，也就是使用主键索引查询一条记录，那么执行器与存储引擎的执行流程是这样的：</p>

<blockquote>
  <p>1、执行器第一次查询，会调用 read_first_record 函数指针指向的函数，因为优化器选择的访问类型为 const，这个函数指针被指向为 InnoDB 引擎索引查询的接口，把条件 id = 1 交给存储引擎，让存储引擎定位符合条件的第一条记录。</p>

  <p>2、存储引擎通过主键索引的 B+ 树结构定位到 id = 1的第一条记录，如果记录是不存在的，就会向执行器上报记录找不到的错误，然后查询结束。如果记录是存在的，就会将记录返回给执行器；</p>

  <p>3、执行器从存储引擎读到记录后，接着判断记录是否符合查询条件，如果符合则发送给客户端，如果不符合则跳过该记录。</p>

  <p>4、执行器查询的过程是一个 while 循环，所以还会再查一次，但是这次因为不是第一次查询了，所以会调用 read_record 函数指针指向的函数，因为优化器选择的访问类型为 const，这个函数指针被指向为一个永远返回 - 1 的函数，所以当调用该函数的时候，执行器就退出循环，也就是结束查询了。</p>
</blockquote>

<p>全表扫描</p>

<div class="language-sql highlighter-rouge"><div class="highlight"><pre class="highlight"><code> <span class="k">select</span> <span class="o">*</span> <span class="k">from</span> <span class="n">product</span> <span class="k">where</span> <span class="n">name</span> <span class="o">=</span> <span class="s1">'iphone'</span><span class="p">;</span>
</code></pre></div></div>

<p>以上面的SQL语句为例，这条查询语句的查询条件没有用到索引，所以优化器决定选用访问类型为 ALL 进行查询，也就是全表扫描的方式查询，那么这时执行器与存储引擎的执行流程是这样的：</p>

<blockquote>
  <p>1、执行器第一次查询，会调用 read_first_record 函数指针指向的函数，因为优化器选择的访问类型为 all，这个函数指针被指向为 InnoDB 引擎全扫描的接口，让存储引擎读取表中的第一条记录；</p>

  <p>执行器会判断读到的这条记录的 name 是不是 iphone，如果不是则跳过；如果是则将记录发给客户的（是的没错，Server 层每从存储引擎读到一条记录就会发送给客户端，之所以客户端显示的时候是直接显示所有记录的，是因为客户端是等查询语句查询完成后，才会显示出所有的记录）。</p>

  <p>3、执行器查询的过程是一个 while 循环，所以还会再查一次，会调用 read_record 函数指针指向的函数，因为优化器选择的访问类型为 all，read_record 函数指针指向的还是 InnoDB 引擎全扫描的接口，所以接着向存储引擎层要求继续读刚才那条记录的下一条记录，存储引擎把下一条记录取出后就将其返回给执行器（Server层），执行器继续判断条件，不符合查询条件即跳过该记录，否则发送到客户端；</p>

  <p>4、一直重复上述过程，直到存储引擎把表中的所有记录读完，然后向执行器（Server层） 返回了读取完毕的信息；</p>

  <p>5、执行器收到存储引擎报告的查询完毕的信息，退出循环，停止查询。</p>
</blockquote>

<p>索引下推</p>

<p>mysql 5.6 推出的查询优化策略。</p>

<p>索引下推能够<strong>减少</strong> <strong>二级索引</strong> 在查询时的<strong>回表操作</strong>，提高查询效率，因为它将 server 层部分负责的事交给了存储引擎层去处理。</p>

<div class="language-sql highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="err">有一个字段如下的表，且对</span> <span class="n">age</span> <span class="err">和</span> <span class="n">reward</span> <span class="err">字段建立了联合索引。</span>
 <span class="n">id</span>    <span class="n">name</span>     <span class="n">age</span>      <span class="n">reward</span>
 
 <span class="err">有如下的查询语句</span>
 <span class="k">select</span> <span class="o">*</span> <span class="k">from</span> <span class="n">t_user</span> <span class="k">where</span> <span class="n">age</span> <span class="o">&gt;</span> <span class="mi">20</span> <span class="k">and</span> <span class="n">reward</span> <span class="o">=</span> <span class="mi">100000</span><span class="p">;</span>
</code></pre></div></div>

<p>联合索引当遇到范围查询 (&gt;、&lt;) 就会停止匹配，也就是 <strong>age 字段能用到联合索引，但是 reward 字段则无法利用到索引</strong>。</p>

<p>不使用索引下推时（mysql 5.6版本之前），执行器与存储引擎的执行流程如下：</p>

<blockquote>
  <p>1、Server 层首先调用存储引擎的接口定位到满足查询条件的第一条二级索引记录，也就是定位到 age &gt; 20 的第一条记录；</p>

  <p>2、存储引擎根据二级索引的 B+ 树快速定位到这条记录后，获取主键值，然后进行回表操作，将完整的记录返回给 Server 层；</p>

  <p>3、Server 层在判断该记录的 reward 是否等于 100000，如果成立则将其发送给客户端；否则跳过该记录；</p>

  <p>4、接着，继续向存储引擎索要下一条记录，存储引擎在二级索引定位到记录后，获取主键值，然后回表操作，将完整的记录返回给 Server 层；</p>

  <p>5、如此往复，直到存储引擎把表中的所有记录读完。</p>

  <p>可以看到，没有索引下推的时候，每查询到一条二级索引记录，都要进行回表操作，然后将记录返回给 Server，接着 Server 再判断该记录的 reward 是否等于 100000。</p>
</blockquote>

<p>而使用索引下推后，判断记录的 reward 是否等于 100000 的工作交给了存储引擎层，过程如下 ：</p>

<blockquote>
  <p>1、Server 层首先调用存储引擎的接口定位到满足查询条件的第一条二级索引记录，也就是定位到 age &gt; 20 的第一条记录；</p>

  <p>存储引擎定位到二级索引后，先不执行回表操作，而是先判断一下该索引中包含的列（reward列）的条件（reward 是否等于 100000）是否成立。如果条件不成立，则直接跳过该二级索引。如果成立，则执行回表操作，将完成记录返回给 Server 层。</p>

  <p>3、Server 层在判断其他的查询条件（本次查询没有其他条件）是否成立，如果成立则将其发送给客户端；否则跳过该记录，然后向存储引擎索要下一条记录。</p>

  <p>4、如此往复，直到存储引擎把表中的所有记录读完。</p>

  <p>可以看到，使用了索引下推后，虽然 reward 列无法使用到联合索引，但是因为它包含在联合索引（age，reward）里，所以直接在存储引擎过滤出满足 reward = 100000 的记录后，才去执行回表操作获取整个记录。相比于没有使用索引下推，节省了很多回表操作。</p>
</blockquote>

<h2 id="总结">总结</h2>

<p>执行一条 SQL 查询语句，期间发生了什么？</p>

<ul>
  <li>连接器：建立连接，管理连接、校验用户身份；</li>
  <li>查询缓存：查询语句如果命中查询缓存则直接返回，否则继续往下执行。MySQL 8.0 已删除该模块；</li>
  <li>解析 SQL，通过解析器对 SQL 查询语句进行词法分析、语法分析，然后构建语法树，方便后续模块读取表名、字段、语句类型；</li>
  <li>执行 SQL：执行 SQL 共有三个阶段：
    <ul>
      <li>预处理阶段：检查表或字段是否存在；将 <code class="language-plaintext highlighter-rouge">select *</code> 中的 <code class="language-plaintext highlighter-rouge">*</code> 符号扩展为表上的所有列。</li>
      <li>优化阶段：基于查询成本的考虑， 选择查询成本最小的执行计划；</li>
      <li>执行阶段：根据执行计划执行 SQL 查询语句，从存储引擎读取记录，返回给客户端；</li>
    </ul>
  </li>
</ul>]]></content><author><name>Xudu</name></author><category term="八股文" /><category term="MySQL" /><category term="学习笔记" /><summary type="html"><![CDATA[由一条select语句的执行流程，了解MySQL的内部结构！]]></summary></entry><entry><title type="html">Java并发编程</title><link href="https://xuduyinuo.cn/Multithreading/" rel="alternate" type="text/html" title="Java并发编程" /><published>2025-12-18T20:22:20+08:00</published><updated>2025-12-18T20:22:20+08:00</updated><id>https://xuduyinuo.cn/Multithreading</id><content type="html" xml:base="https://xuduyinuo.cn/Multithreading/"><![CDATA[<p>多线程是指在一个程序中同时执行多个线程，每个线程都有自己独立的执行路径。在多线程中，程序的执行可以同时进行多个任务，从而提高系统的资源利用率和响应性能。</p>

<!-- more -->

<h2 id="概述">概述</h2>

<p>多线程是指在一个程序中同时执行多个线程，每个线程都有自己独立的执行路径。在多线程中，程序的执行可以同时进行多个任务，从而提高系统的资源利用率和响应性能。</p>

<p>在传统的单线程编程模型中，程序按照顺序执行，一次只处理一个任务。这种方式在某些情况下可能会导致效率低下或者无法满足需求。而多线程通过将任务拆分为多个子任务，并且在不同的线程上同时执行，从而实现并发处理。</p>

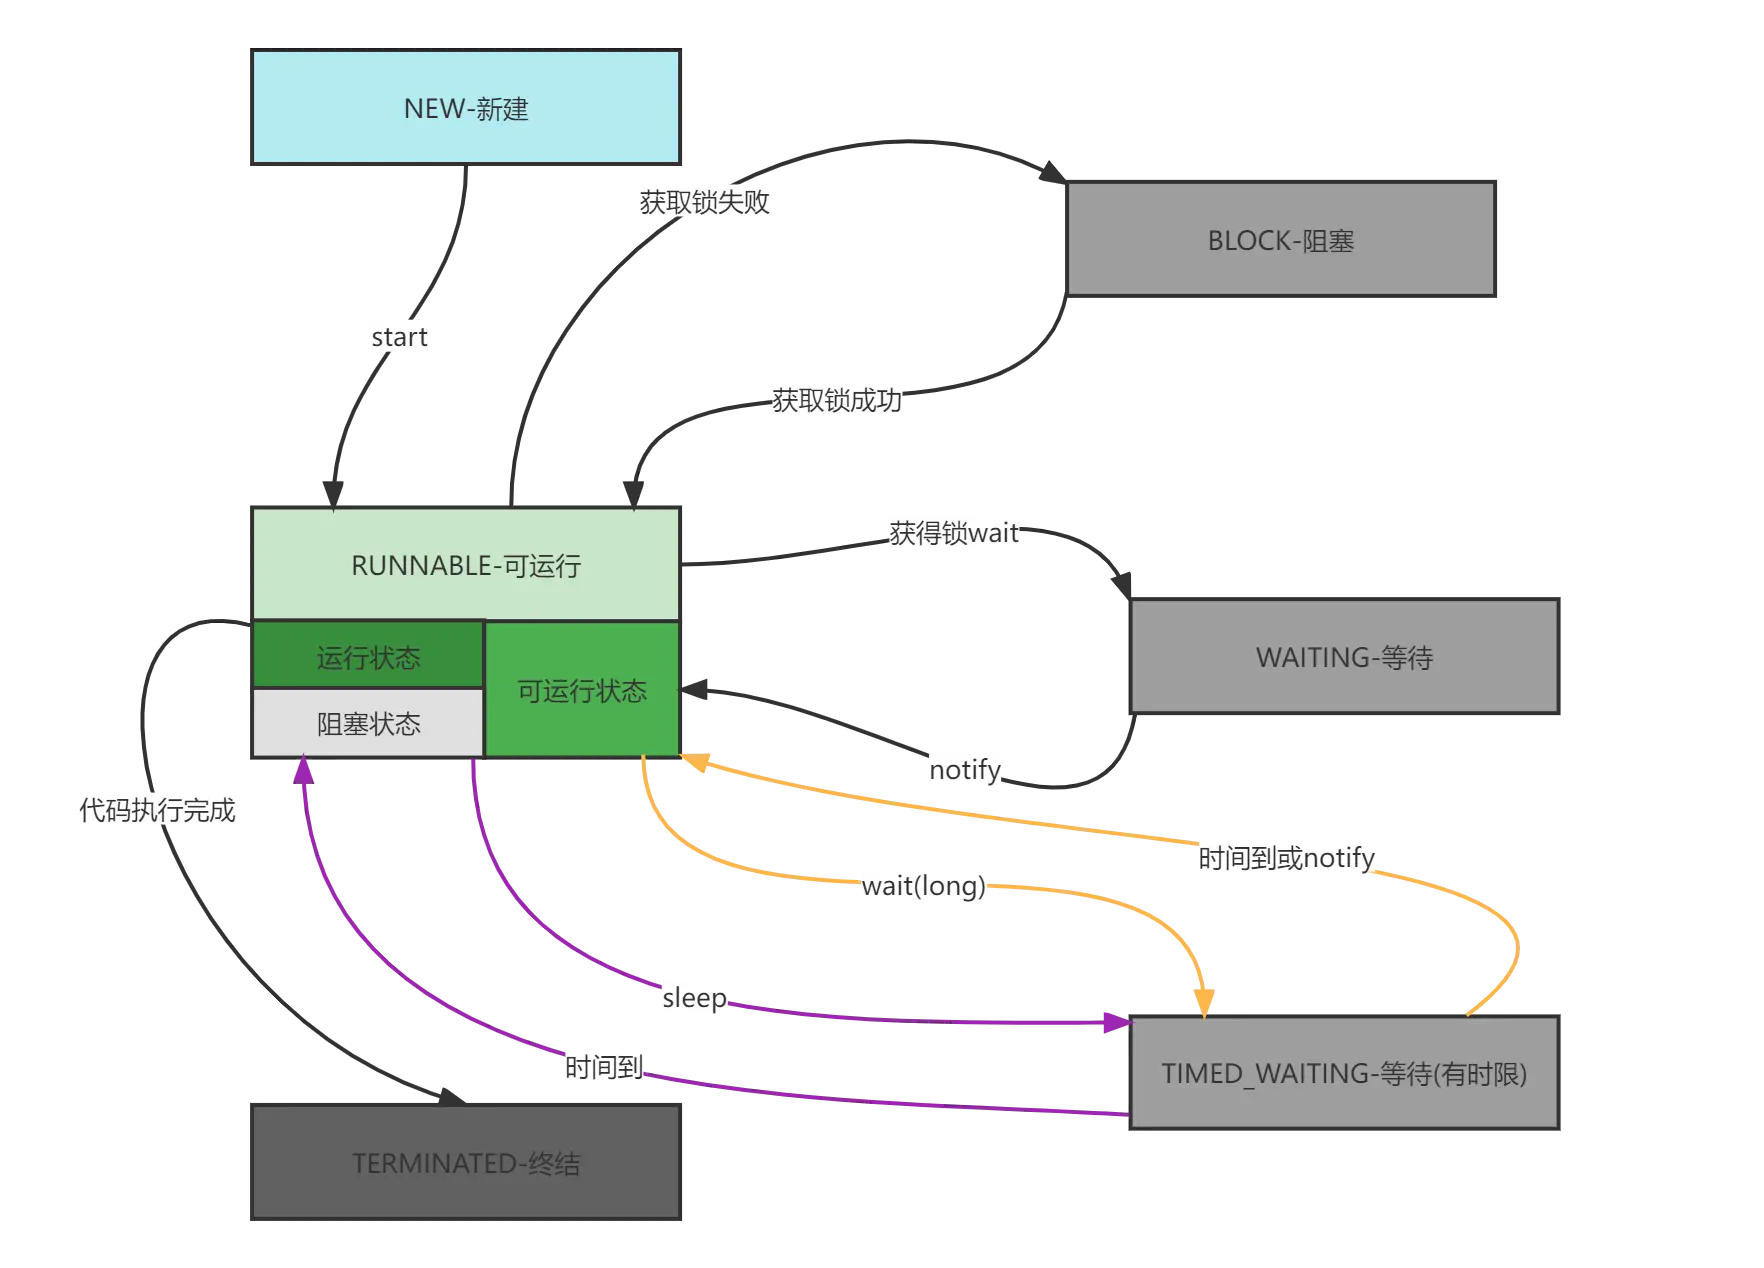
<h2 id="线程的状态">线程的状态</h2>

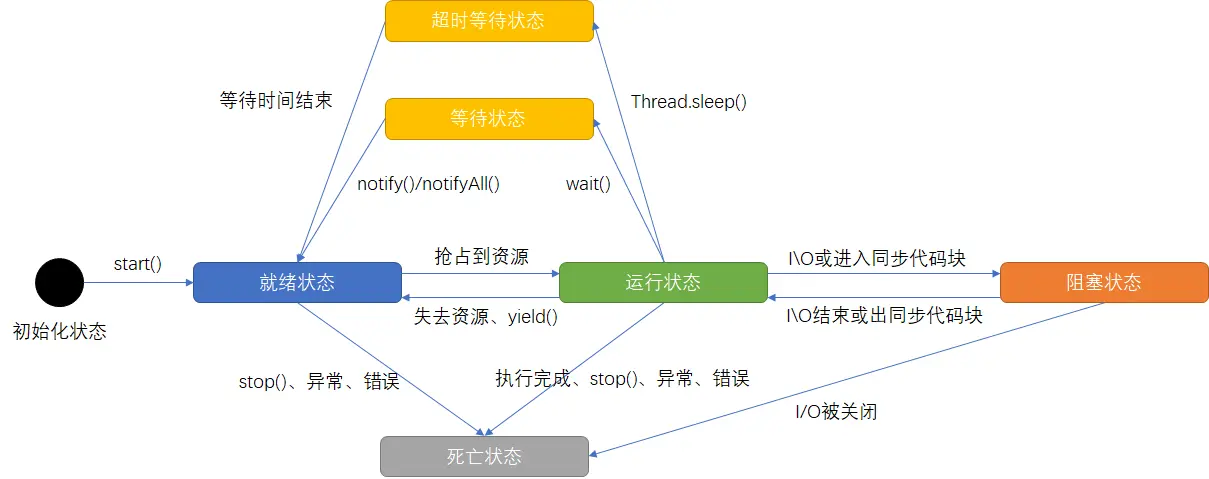
<p>操作系统层面划分线程状态</p>

<p><img src="../images/Multithreading/thread-status.webp" alt="操作系统层面划分线程状态" /></p>

<p>java代码层面划分线程状态</p>

<p><img src="../images/Multithreading/thread-status-java.webp" alt="java代码层面划分线程状态" /></p>

<h2 id="四种创建线程的方式">四种创建线程的方式</h2>

<h3 id="继承-thread-类">继承 Thread 类</h3>

<p>继承 Thread 类并重写 run() 方法，直接创建 Thread 子类对象并调用 start() 方法启动线程。</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Slf4j</span>
<span class="kd">class</span> <span class="nc">MyThread</span> <span class="kd">extends</span> <span class="nc">Thread</span> <span class="o">{</span>
    <span class="kd">public</span> <span class="nf">MyThread</span><span class="o">(</span><span class="nc">String</span> <span class="n">name</span><span class="o">)</span> <span class="o">{</span>
        <span class="kd">super</span><span class="o">(</span><span class="n">name</span><span class="o">);</span>  <span class="c1">// 调用父类 Thread 的构造函数设置名称</span>
    <span class="o">}</span>
    <span class="nd">@Override</span>
    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">run</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">i</span> <span class="o">=</span> <span class="mi">0</span><span class="o">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="mi">3</span><span class="o">;</span> <span class="n">i</span><span class="o">++){</span>
            <span class="n">log</span><span class="o">.</span><span class="na">info</span><span class="o">(</span><span class="s">"Thread ：{}"</span><span class="o">,</span> <span class="n">i</span><span class="o">);</span>
        <span class="o">}</span>
    <span class="o">}</span>
<span class="o">}</span>

<span class="k">new</span> <span class="nf">MyThread</span><span class="o">(</span><span class="s">"haibara"</span><span class="o">).</span><span class="na">start</span><span class="o">();</span>
</code></pre></div></div>

<h3 id="实现-runnable-接口">实现 Runnable 接口</h3>

<p>实现 Runnable 接口的 run() 方法，使用 Thread 类的构造函数传入 Runnable 对象，调用 start() 方法启动线程。</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Slf4j</span>
<span class="kd">class</span> <span class="nc">MyRunnable</span> <span class="kd">implements</span> <span class="nc">Runnable</span> <span class="o">{</span>
    <span class="nd">@Override</span>
    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">run</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">i</span> <span class="o">=</span> <span class="mi">0</span><span class="o">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="mi">3</span><span class="o">;</span> <span class="n">i</span><span class="o">++){</span>
            <span class="n">log</span><span class="o">.</span><span class="na">info</span><span class="o">(</span><span class="s">"Runable ：{}"</span><span class="o">,</span> <span class="n">i</span><span class="o">);</span>
        <span class="o">}</span>
    <span class="o">}</span>
<span class="o">}</span>

<span class="k">new</span> <span class="nf">Thread</span><span class="o">(</span><span class="k">new</span> <span class="nc">MyRunnable</span><span class="o">(),</span> <span class="s">"xudu"</span><span class="o">).</span><span class="na">start</span><span class="o">();</span>
</code></pre></div></div>

<h3 id="使用-callable-和-futuretask">使用 Callable 和 FutureTask</h3>

<p>实现 Callable 接口的 call() 方法，使用 FutureTask 包装 Callable 对象，再通过 Thread 启动。</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Slf4j</span>
<span class="kd">class</span> <span class="nc">MyCallable</span> <span class="kd">implements</span> <span class="nc">Callable</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">&gt;</span> <span class="o">{</span>
    <span class="nd">@Override</span>
    <span class="kd">public</span> <span class="nc">String</span> <span class="nf">call</span><span class="o">()</span> <span class="kd">throws</span> <span class="nc">Exception</span> <span class="o">{</span>
        <span class="n">log</span><span class="o">.</span><span class="na">info</span><span class="o">(</span><span class="s">"Callable hello"</span><span class="o">);</span>
        <span class="k">return</span> <span class="s">"success"</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>

<span class="nc">FutureTask</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">&gt;</span> <span class="n">futureTask</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">FutureTask</span><span class="o">&lt;&gt;(</span><span class="k">new</span> <span class="nc">MyCallable</span><span class="o">());</span>

<span class="k">new</span> <span class="nf">Thread</span><span class="o">(</span><span class="n">futureTask</span><span class="o">,</span> <span class="s">"yinuo"</span><span class="o">).</span><span class="na">start</span><span class="o">();</span>
</code></pre></div></div>

<h3 id="使用自定义线程池">使用自定义线程池</h3>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nc">ThreadPoolExecutor</span> <span class="n">poolExecutor</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">ThreadPoolExecutor</span><span class="o">(</span>
                <span class="mi">2</span><span class="o">,</span>
                <span class="mi">4</span><span class="o">,</span>
                <span class="mi">30</span><span class="o">,</span>
                <span class="nc">TimeUnit</span><span class="o">.</span><span class="na">SECONDS</span><span class="o">,</span>
                <span class="k">new</span> <span class="nc">ArrayBlockingQueue</span><span class="o">&lt;&gt;(</span><span class="mi">10</span><span class="o">),</span>
                <span class="k">new</span> <span class="nf">NamedThreadFactory</span><span class="o">(</span><span class="s">"xudu"</span><span class="o">),</span>
                <span class="k">new</span> <span class="nc">ThreadPoolExecutor</span><span class="o">.</span><span class="na">CallerRunsPolicy</span><span class="o">()</span>
        <span class="o">);</span>

        <span class="n">poolExecutor</span><span class="o">.</span><span class="na">execute</span><span class="o">(</span><span class="k">new</span> <span class="nc">MyRunnable</span><span class="o">());</span>
        <span class="n">poolExecutor</span><span class="o">.</span><span class="na">shutdown</span><span class="o">();</span>
</code></pre></div></div>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">class</span> <span class="nc">NamedThreadFactory</span> <span class="kd">implements</span> <span class="nc">ThreadFactory</span> <span class="o">{</span>

    <span class="kd">private</span> <span class="kd">final</span> <span class="nc">AtomicInteger</span> <span class="n">index</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">AtomicInteger</span><span class="o">(</span><span class="mi">1</span><span class="o">);</span>
    <span class="kd">private</span> <span class="kd">final</span> <span class="nc">String</span> <span class="n">prefix</span><span class="o">;</span>

    <span class="kd">public</span> <span class="nf">NamedThreadFactory</span><span class="o">(</span><span class="nc">String</span> <span class="n">prefix</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">this</span><span class="o">.</span><span class="na">prefix</span> <span class="o">=</span> <span class="n">prefix</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="nd">@Override</span>
    <span class="kd">public</span> <span class="nc">Thread</span> <span class="nf">newThread</span><span class="o">(</span><span class="nc">Runnable</span> <span class="n">r</span><span class="o">)</span> <span class="o">{</span>
        <span class="nc">Thread</span> <span class="n">t</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">Thread</span><span class="o">(</span><span class="n">r</span><span class="o">);</span>
        <span class="n">t</span><span class="o">.</span><span class="na">setName</span><span class="o">(</span><span class="n">prefix</span> <span class="o">+</span> <span class="s">"-"</span> <span class="o">+</span> <span class="n">index</span><span class="o">.</span><span class="na">getAndIncrement</span><span class="o">());</span>
        <span class="k">return</span> <span class="n">t</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p>Runnable vs Callable：</p>

<p>Runnable 的 run() 方法不返回结果，不能抛出检查异常；Callable 的 call() 方法可以返回结果，并允许抛出检查异常。使用 Callable 更适合需要返回结果或处理异常的并发任务。</p>

<p>Java语言支持多实现，一个类可以实现多个接口，因此可以更灵活地创建线程。</p>

<p>通过实现Runnable接口，可以将任务逻辑与线程的启动和管理逻辑分离，使代码更清晰、结构更合理。</p>

<p>Runnable对象可以作为参数传递给其他线程或线程池，实现更高级的线程管理和复用。</p>

<h2 id="线程常用方法">线程常用方法</h2>

<ul>
  <li>
    <p>start()</p>

    <p>启动一个新线程，在新的线程运行 run 方法中的代码。start 方法只是让线程进入就绪，里面代码不一定立刻运行（CPU 的时间片还没分给它）。每个线程对象的start方法只能调用一次，如果调用了多次会出现IllegalThreadStateException</p>
  </li>
  <li>
    <p>run()</p>

    <p>新线程启动后会调用的方法。如果在构造 Thread 对象时传递了 Runnable 参数，则线程启动后会调用 Runnable 中的 run 方法，否则默认不执行任何操作。但可以创建 Thread 的子类对象，来覆盖默认行为</p>
  </li>
  <li>
    <p>join() / join(long n)</p>

    <p>等待线程运行结束</p>
  </li>
  <li>
    <p>getId()</p>

    <p>获取线程长整型的唯一 id</p>
  </li>
  <li>
    <p>getName() / setName(String)</p>

    <p>获取/修改 线程名</p>
  </li>
  <li>
    <p>getPriority() / setPriority(int)</p>

    <p>获取/修改 线程优先级。java中规定线程优先级是1~10 的整数，较大的优先级能提高该线程被 CPU 调度的机率</p>
  </li>
  <li>
    <p>getState()</p>

    <p>获取线程状态，NEW、RUNNABLE、BLOCKED、WAITING、TIMED_WAITING、TERMINATED</p>
  </li>
  <li>
    <p>isInterrupted()</p>

    <p>判断是否被打断， 不会清除打断标记</p>
  </li>
  <li>
    <p>isAlive()</p>

    <p>线程是否存活（还没有运行完毕）</p>
  </li>
  <li>
    <p>interrupt()</p>

    <p>打断线程，如果被打断线程正在 sleep，wait，join 会导致被打断的线程抛出 InterruptedException，并清除打断标记；如果打断的正在运行的线程，则会设置打断标记 ；park 的线程被打断，也会设置打断标记</p>
  </li>
  <li>
    <p>interrupted()</p>

    <p>判断当前线程是否被打断 ，会清除打断标记</p>
  </li>
  <li>
    <p>currentThread()</p>

    <p>获取当前正在执行的线程</p>
  </li>
  <li>
    <p>sleep(long n)</p>

    <p>让当前执行的线程休眠n毫秒，休眠时让出 cpu 的时间片给其它线程</p>
  </li>
  <li>
    <p>yield()</p>

    <p>提示线程调度器让出当前线程对CPU的使用，主要是为了测试和调试</p>
  </li>
</ul>

<h2 id="线程安全问题">线程安全问题</h2>

<h3 id="出现线程安全性问题的条件">出现线程安全性问题的条件</h3>

<ol>
  <li>在多线程的环境下</li>
  <li>必须有共享资源</li>
  <li>对共享资源进行非原子性操作</li>
</ol>

<h3 id="解决线程安全性问题的方法"><strong>解决线程安全性问题的方法</strong></h3>

<ul>
  <li>针对多个线程操作同一共享资源——不共享资源（ThreadLocal、不共享、操作无状态化、不可变）</li>
  <li>针对多个线程进行非原子性操作——将非原子性操作改成原子性操作（使用加锁机制来保证可见性和有序性以及原子性、使用JDK自带的原子性操作的类、JUC提供的相应的并发工具类）</li>
</ul>

<h3 id="性能问题"><strong>性能问题</strong></h3>

<ol>
  <li>线程的生命周期开销非常高。在线程切换时存在CPU上下文切换开销，内存同步也存在着开销。</li>
  <li>消耗过多的CPU资源。如果可运行的线程数量多于可用处理器的数量，那么有线程将会被闲置。大量空闲的线程会占用许多内存，给垃圾回收器带来压力，而且大量的线程在竞争CPU资源时还将产生其他性能的开销。</li>
  <li>降低稳定性</li>
</ol>

<p>什么是死锁？</p>

<p>两个或多个线程在执行过程中，因争夺资源而形成的一种相互等待的状态，若无外力干预，这些线程都将无法继续执行。</p>

<p>什么是活锁？</p>

<p>多个线程持续改变状态以响应对方的行为，但始终无法推进程序进展的一种状态。</p>

<h2 id="线程同步">线程同步</h2>

<h3 id="synchronized的用法">synchronized的用法</h3>

<p>修饰方法</p>

<p>修饰普通方法，相当于锁当前对象，调用者，即指 this对象</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">public</span> <span class="kd">synchronized</span> <span class="kt">void</span> <span class="nf">method</span><span class="o">()</span> <span class="o">{</span>
  <span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">println</span><span class="o">(</span><span class="s">"do something"</span><span class="o">);</span>
<span class="o">}</span>
</code></pre></div></div>

<p>修饰静态方法，相当于锁当前类对象，也指 className.class</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">public</span> <span class="kd">static</span> <span class="kd">synchronized</span> <span class="kt">void</span> <span class="nf">method</span><span class="o">()</span> <span class="o">{</span>
  <span class="n">log</span><span class="o">.</span><span class="na">info</span><span class="o">(</span><span class="s">"do something"</span><span class="o">);</span>
<span class="o">}</span>
</code></pre></div></div>

<p>修饰代码块【可以缩小锁的范围，提升性能】</p>

<p>锁普通对象和锁this</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">public</span> <span class="kt">void</span> <span class="nf">method</span><span class="o">()</span> <span class="o">{</span>
  <span class="kd">synchronized</span><span class="o">(</span><span class="k">this</span><span class="o">)</span> <span class="o">{</span>
    <span class="n">log</span><span class="o">.</span><span class="na">info</span><span class="o">(</span><span class="s">"do something"</span><span class="o">);</span>
  <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p>锁定类对象className.class</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">public</span> <span class="kt">void</span> <span class="nf">method</span><span class="o">()</span> <span class="o">{</span>
  <span class="kd">synchronized</span><span class="o">(</span><span class="nc">SynchronizedTest</span><span class="o">.</span><span class="na">class</span><span class="o">)</span> <span class="o">{</span>
    <span class="n">log</span><span class="o">.</span><span class="na">info</span><span class="o">(</span><span class="s">"do something"</span><span class="o">);</span>
  <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<h3 id="lock-接口">Lock 接口</h3>

<p>常用实现：ReentrantLock</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nc">Lock</span> <span class="n">lock</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">ReentrantLock</span><span class="o">();</span>
<span class="n">lock</span><span class="o">.</span><span class="na">lock</span><span class="o">();</span>
<span class="k">try</span> <span class="o">{</span>
    <span class="c1">// 临界区</span>
<span class="o">}</span> <span class="k">finally</span> <span class="o">{</span>
    <span class="n">lock</span><span class="o">.</span><span class="na">unlock</span><span class="o">();</span>
<span class="o">}</span>
</code></pre></div></div>

<h3 id="原子类">原子类</h3>

<p>java 中的原子类是通过使用硬件提供的原子操作指令（如 CAS，Compare-And-Swap）来确保操作的原子性，从而避免线程竞争问题。</p>

<p>常用的原子类有以下几种：</p>

<ol>
  <li>AtomicInteger：用于操作整数的原子类，提供了原子性的自增、自减、加法等操作。</li>
  <li>AtomicLong：与 AtomicInteger 类似，但用于操作 long 型数据。</li>
  <li>AtomicBoolean：用于操作布尔值的原子类，提供了原子性的布尔值比较和设置操作。</li>
  <li>AtomicReference：用于操作对象引用的原子类，支持对引用对象的原子更新。</li>
  <li>AtomicStampedReference：在 AtomicReference 的基础上，增加了时间戳或版本号的比较，避免了 ABA 问题。</li>
  <li>AtomicIntegerArray 和 AtomicLongArray：分别是 AtomicInteger 和 AtomicLong 的数组版本，提供了对数组中各个元素的原子操作。</li>
</ol>

<h3 id="并发工具类">并发工具类</h3>

<h4 id="countdownlatch">CountDownLatch</h4>

<p>作用： 一个线程（或多个）等待其他线程完成操作。</p>

<p>用法： 适用于主线程需要等待多个子线程完成任务的场景。</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nc">CountDownLatch</span> <span class="n">latch</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">CountDownLatch</span><span class="o">(</span><span class="mi">3</span><span class="o">);</span>
<span class="nc">Runnable</span> <span class="n">task</span> <span class="o">=</span> <span class="o">()</span> <span class="o">-&gt;</span> <span class="o">{</span>
    <span class="k">try</span> <span class="o">{</span>
        <span class="c1">// 执行任务</span>
    <span class="o">}</span> <span class="k">finally</span> <span class="o">{</span>
        <span class="n">latch</span><span class="o">.</span><span class="na">countDown</span><span class="o">();</span> <span class="c1">// 任务完成，计数器减一</span>
    <span class="o">}</span>
<span class="o">};</span>
<span class="k">new</span> <span class="nf">Thread</span><span class="o">(</span><span class="n">task</span><span class="o">).</span><span class="na">start</span><span class="o">();</span>
<span class="n">latch</span><span class="o">.</span><span class="na">await</span><span class="o">();</span> <span class="c1">// 等待所有任务完成</span>
<span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">println</span><span class="o">(</span><span class="s">"所有任务都完成了"</span><span class="o">);</span>
</code></pre></div></div>

<h4 id="cyclicbarrier">CyclicBarrier</h4>

<p>作用：让一组线程到达一个共同的同步点，然后一起继续执行。常用于分阶段任务执行。</p>

<p>用法：适用于需要所有线程在某个点都完成后再继续的场景。</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nc">CyclicBarrier</span> <span class="n">barrier</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">CyclicBarrier</span><span class="o">(</span><span class="mi">3</span><span class="o">,</span> <span class="o">()</span> <span class="o">-&gt;</span> <span class="o">{</span>
    <span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">println</span><span class="o">(</span><span class="s">"所有线程都到达了屏障点"</span><span class="o">);</span>
<span class="o">});</span>
<span class="nc">Runnable</span> <span class="n">task</span> <span class="o">=</span> <span class="o">()</span> <span class="o">-&gt;</span> <span class="o">{</span>
    <span class="k">try</span> <span class="o">{</span>
        <span class="c1">// 执行任务</span>
        <span class="n">barrier</span><span class="o">.</span><span class="na">await</span><span class="o">();</span> <span class="c1">// 等待其他线程</span>
    <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">Exception</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
        <span class="n">e</span><span class="o">.</span><span class="na">printStackTrace</span><span class="o">();</span>
    <span class="o">}</span>
<span class="o">};</span>
<span class="k">new</span> <span class="nf">Thread</span><span class="o">(</span><span class="n">task</span><span class="o">).</span><span class="na">start</span><span class="o">();</span>
</code></pre></div></div>

<h4 id="semaphore">Semaphore</h4>

<p>作用： 控制访问资源的线程数，可以用来实现限流或访问控制。</p>

<p>用法： 在资源有限的情况下，控制同时访问的线程数量。</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nc">Semaphore</span> <span class="n">semaphore</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">Semaphore</span><span class="o">(</span><span class="mi">3</span><span class="o">);</span>
<span class="k">try</span> <span class="o">{</span>
    <span class="n">semaphore</span><span class="o">.</span><span class="na">acquire</span><span class="o">();</span> <span class="c1">// 获取许可</span>
    <span class="c1">// 执行任务</span>
<span class="o">}</span> <span class="k">finally</span> <span class="o">{</span>
    <span class="n">semaphore</span><span class="o">.</span><span class="na">release</span><span class="o">();</span> <span class="c1">// 释放许可</span>
<span class="o">}</span>
</code></pre></div></div>

<h4 id="blockingqueue">BlockingQueue</h4>

<p>作用： 是一个线程安全的队列，支持阻塞操作，适用于生产者-消费者模式。</p>

<p>用法： 生产者线程将元素放入队列，消费者线程从队列中取元素，队列为空时消费者线程阻塞。</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nc">BlockingQueue</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">&gt;</span> <span class="n">queue</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">LinkedBlockingQueue</span><span class="o">&lt;&gt;();</span>
<span class="nc">Runnable</span> <span class="n">producer</span> <span class="o">=</span> <span class="o">()</span> <span class="o">-&gt;</span> <span class="o">{</span>
    <span class="k">try</span> <span class="o">{</span>
        <span class="n">queue</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="s">"item"</span><span class="o">);</span> <span class="c1">// 放入元素</span>
    <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">InterruptedException</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
        <span class="n">e</span><span class="o">.</span><span class="na">printStackTrace</span><span class="o">();</span>
    <span class="o">}</span>
<span class="o">};</span>
<span class="nc">Runnable</span> <span class="n">consumer</span> <span class="o">=</span> <span class="o">()</span> <span class="o">-&gt;</span> <span class="o">{</span>
    <span class="k">try</span> <span class="o">{</span>
        <span class="nc">String</span> <span class="n">item</span> <span class="o">=</span> <span class="n">queue</span><span class="o">.</span><span class="na">take</span><span class="o">();</span> <span class="c1">// 取出元素</span>
    <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">InterruptedException</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
        <span class="n">e</span><span class="o">.</span><span class="na">printStackTrace</span><span class="o">();</span>
    <span class="o">}</span>
<span class="o">};</span>
<span class="k">new</span> <span class="nf">Thread</span><span class="o">(</span><span class="n">producer</span><span class="o">).</span><span class="na">start</span><span class="o">();</span>
<span class="k">new</span> <span class="nf">Thread</span><span class="o">(</span><span class="n">consumer</span><span class="o">).</span><span class="na">start</span><span class="o">();</span>
</code></pre></div></div>

<h2 id="线程池">线程池</h2>

<h3 id="原理">原理</h3>

<p>线程池是一种池化技术，用于预先创建并管理一组线程，避免频繁创建和销毁线程的开销，提高性能和响应速度。</p>

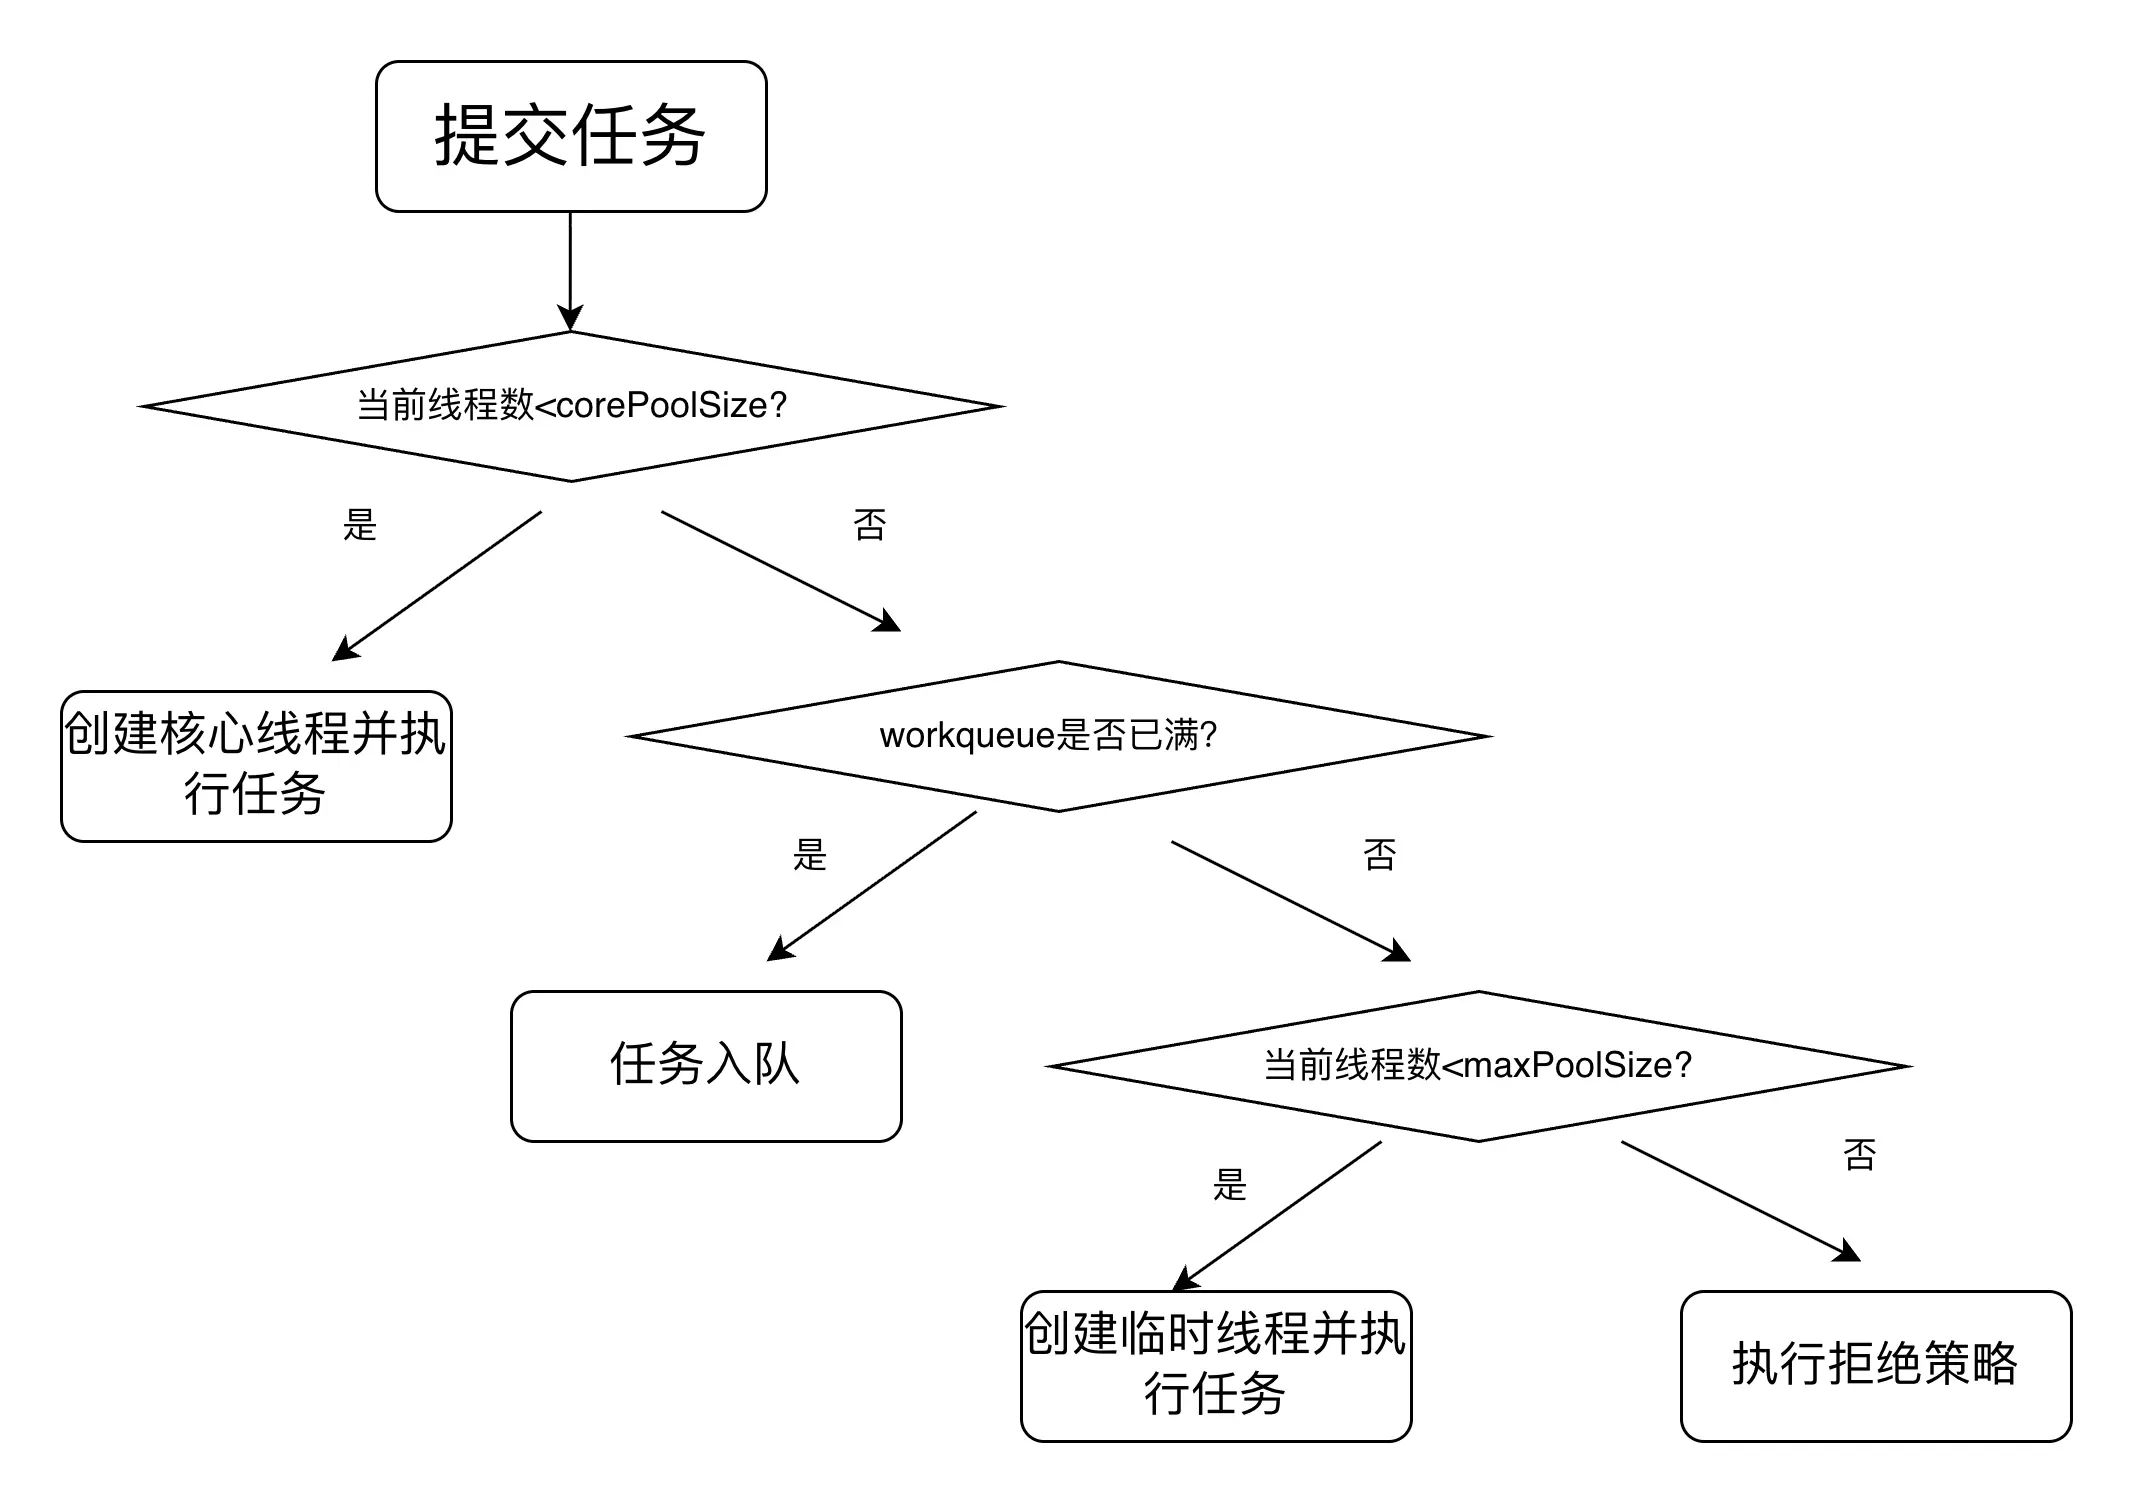
<p>它几个关键的配置包括：核心线程数、最大线程数、空闲存活时间、工作队列、拒绝策略。</p>

<p>主要工作原理如下：</p>

<ol>
  <li>默认情况下线程不会预创建，任务提交之后才会创建线程（不过设置 prestartAllCoreThreads 可以预创建核心线程）。</li>
  <li>当核心线程满了之后不会新建线程，而是把任务堆积到工作队列中。</li>
  <li>如果工作队列放不下了，然后才会新增线程，直至达到最大线程数。</li>
  <li>如果工作队列满了，然后也已经达到最大线程数了，这时候来任务会执行拒绝策略。</li>
  <li>如果线程空闲时间超过空闲存活时间，并且当前线程数大于核心线程数的则会销毁线程，直到线程数等于核心线程数（设置 allowCoreThreadTimeOut 为 true 可以回收核心线程，默认为 false）。</li>
</ol>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="cm">/**
 * corePoolSize:线程池的核心大小，当提交一个任务到线程池时，线程池会创建一个线程来执行任务
 *              即使其他空闲的基本线程能够执行新任务也会创建线程，如需要执行的任务数大于线
 *              程池基本大小时就不再创建。如果调用了线程池的prestartAllCoreThreads()方法
 *              线程池会提前创建并启动所有基本线程。
 * maximumPoolSize:线程池最大大小，线程池允许创建的最大线程数。如果队列满了，并且已创建的线程数
 *                 小于最大线程数大于等于核心线程数，则线程池会再创建新的线程执行任务。如果使用
 *                 了无界的任务队列这个参数就没什么效果。
 * keepAliveTime:临时线程活动保持时间，线程池的工作线程空闲后，保持存活的时间。所以如果任务很多
 *               并且每个任务执行的时间比较短，可以调大这个时间，提高线程的利用率。
 * TimeUnit:临时线程活动保持时间的单位，可选的单位有天(DAYS)，小时(HOURS)，分钟(MINUTES)，
 *          毫秒(MILLISECONDS)，微秒(MICROSECONDS, 千分之一毫秒)和毫微秒(NANOSECONDS, 
 *          千分之一微秒)
 * workQueue:任务对列，用于保存等待执行的任务的阻塞队列
 *           - ArrayBlockingQueue：基于数组结构的有界阻塞队列
 *           - LinkedBlockingQueue：基于链表的阻塞队列,如果没构造函数没传入队列大小则为无界队列
 *                                  Executors.newFixedThreadPool()使用了这个队列
 *           - SynchronousQueue：一个不存储元素的阻塞队列。每个插入操作必须等到另一个线程调用
 *                               移除操作，否则插入操作一直处于阻塞状态
 *                               Executors.newCachedThreadPool使用了这个队列
 *           - PriorityBlockingQueue：个具有优先级得无限阻塞队列
 * threadFactory:用于设置创建线程的工厂，可以通过线程工厂给每个创建出来的线程设置更有意义的名字，
 *               Debug和定位问题时非常有帮助。
 * handler:当队列和线程池都满了，必须采取一种策略处理提交的新任务。
 *         - AbortPolicy：默认策略，无法处理新任务时抛出异常
 *         - CallerRunsPolicy：使用调用者所在线程来运行任务
 *         - DiscardOldestPolicy：丢弃队列里最近的一个任务，并执行当前任务
 *         - DiscardPolicy：不处理，丢弃掉
 */</span>
<span class="kd">public</span> <span class="nf">ThreadPoolExecutor</span><span class="o">(</span><span class="kt">int</span> <span class="n">corePoolSize</span><span class="o">,</span> 
                          <span class="kt">int</span> <span class="n">maximumPoolSize</span><span class="o">,</span>
                          <span class="kt">long</span> <span class="n">keepAliveTime</span><span class="o">,</span>
                          <span class="nc">TimeUnit</span> <span class="n">unit</span><span class="o">,</span>
                          <span class="nc">BlockingQueue</span><span class="o">&lt;</span><span class="nc">Runnable</span><span class="o">&gt;</span> <span class="n">workQueue</span><span class="o">,</span>
                          <span class="nc">ThreadFactory</span> <span class="n">threadFactory</span><span class="o">,</span>
                          <span class="nc">RejectedExecutionHandler</span> <span class="n">handler</span><span class="o">);</span>
</code></pre></div></div>

<h3 id="线程池工作流">线程池工作流</h3>

<p><img src="../images/Multithreading/%E7%BA%BF%E7%A8%8B%E6%B1%A0%E5%B7%A5%E4%BD%9C%E6%B5%81.webp" alt="线程池工作流" /></p>

<blockquote>
  <p>线程池采用“懒加载”方式创建线程，以降低资源消耗并提高系统稳定性。</p>
</blockquote>

<h2 id="乐观锁和悲观锁">乐观锁和悲观锁</h2>

<h3 id="什么是悲观锁">什么是悲观锁？</h3>

<p>悲观锁总是假设最坏的情况，认为共享资源每次被访问的时候就会出现问题(比如共享数据被修改)，所以每次在获取资源操作的时候都会上锁，这样其他线程想拿到这个资源就会阻塞直到锁被上一个持有者释放。也就是说，共享资源每次只给一个线程使用，其它线程阻塞，用完后再把资源转让给其它线程。</p>

<p>像 Java 中synchronized和ReentrantLock等独占锁就是悲观锁思想的实现。</p>

<p>高并发的场景下，激烈的锁竞争会造成线程阻塞，大量阻塞线程会导致系统的上下文切换，增加系统的性能开销。并且，悲观锁还可能会存在死锁问题（线程获得锁的顺序不当时），影响代码的正常运行。</p>

<h3 id="什么是乐观锁">什么是乐观锁？</h3>

<p>乐观锁总是假设最好的情况，认为共享资源每次被访问的时候不会出现问题，线程可以不停地执行，无需加锁也无需等待，只是在提交修改的时候去验证对应的资源（也就是数据）是否被其它线程修改了（具体方法可以使用版本号机制或 CAS 算法）</p>

<p>高并发的场景下，乐观锁相比悲观锁来说，不存在锁竞争造成线程阻塞，也不会有死锁问题，在性能上往往会更胜一筹。但是，如果冲突频繁发生（写占比非常多的情况），会频繁失败并重试，这样同样会非常影响性能，导致 CPU 飙升。</p>

<h3 id="如何实现乐观锁">如何实现乐观锁？</h3>

<h4 id="版本号机制">版本号机制</h4>

<p>一般是在数据表中加上一个数据版本号 version 字段，表示数据被修改的次数。当数据被修改时，version 值会加一。当线程 A 要更新数据值时，在读取数据的同时也会读取 version 值，在提交更新时，若刚才读取到的 version 值为当前数据库中的 version 值相等时才更新，否则重试更新操作，直到更新成功。</p>

<p>举一个简单的例子：假设数据库中帐户信息表中有一个 version 字段，当前值为 1 ；而当前帐户余额字段（ balance ）为 $100 。</p>

<ol>
  <li>操作员 A 此时将其读出（ version=1 ），并从其帐户余额中扣除 50（ 100-$50 ）。</li>
  <li>在操作员 A 操作的过程中，操作员 B 也读入此用户信息（ version=1 ），并从其帐户余额中扣除 20 （ 100-$20 ）。</li>
  <li>操作员 A 完成了修改工作，将数据版本号（ version=1 ），连同帐户扣除后余额（ balance=$50 ），提交至数据库更新，此时由于提交数据版本等于数据库记录当前版本，数据被更新，数据库记录 version 更新为 2 。</li>
  <li>操作员 B 完成了操作，也将版本号（ version=1 ）试图向数据库提交数据（ balance=$80 ），但此时比对数据库记录版本时发现，操作员 B 提交的数据版本号为 1 ，而数据库记录当前版本为 2 ，不满足 “ 提交版本必须等于当前版本才能执行更新 “ 的乐观锁策略，因此，操作员 B 的提交被驳回。</li>
</ol>

<p>这样就避免了操作员 B 用基于 version=1 的旧数据修改的结果覆盖操作员 A 的操作结果的可能。</p>

<h4 id="cas算法">CAS算法</h4>

<p>CAS 的全称是 Compare And Swap（比较与交换） ，用于实现乐观锁，被广泛应用于各大框架中。CAS 的思想很简单，就是用一个预期值和要更新的变量值进行比较，两值相等才会进行更新。</p>

<p>只有当内存中的值等于我期望的旧值时，才把它更新成新值；否则失败。</p>

<p>公式描述：CAS(V, A, B)</p>

<p>V：内存中的变量（当前值）</p>

<p>A：期望的旧值</p>

<p>B：要更新的新值</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1">//执行逻辑，以下比较和赋值是 一个不可分割的原子操作</span>
<span class="k">if</span> <span class="no">V</span> <span class="o">==</span> <span class="nl">A:</span>
    <span class="no">V</span> <span class="o">=</span> <span class="no">B</span>   <span class="c1">// 更新成功</span>
<span class="k">else</span><span class="o">:</span>
    <span class="n">不更新</span> <span class="c1">// 更新失败</span>
</code></pre></div></div>

<p>当多个线程同时使用 CAS 操作一个变量时，只有一个会胜出，并成功更新，其余均会失败，但失败的线程并不会被挂起，仅是被告知失败，并且允许再次尝试，当然也允许失败的线程放弃操作。</p>

<p>存在的问题：</p>

<p>ABA 问题描述</p>

<p>线程 1 读取 A</p>

<p>线程 2 把 A → B → A</p>

<p>线程 1 CAS 发现还是 A，于是成功</p>

<p>但数据其实被改过</p>]]></content><author><name>Xudu</name></author><category term="八股文" /><category term="JUC" /><category term="Java" /><summary type="html"><![CDATA[Java并发编程]]></summary></entry><entry><title type="html">基于强化学习的高效可转移的智能体知识图谱检索增强生成</title><link href="https://xuduyinuo.cn/KG-R1/" rel="alternate" type="text/html" title="基于强化学习的高效可转移的智能体知识图谱检索增强生成" /><published>2025-12-09T12:00:00+08:00</published><updated>2025-12-09T12:00:00+08:00</updated><id>https://xuduyinuo.cn/KG-R1</id><content type="html" xml:base="https://xuduyinuo.cn/KG-R1/"><![CDATA[<p>知识图谱检索增强生成（KG-RAG）通过将大型语言模型（LLM）与结构化、可验证的知识图谱（KG）相结合，从而减轻模型幻觉问题，并显式呈现其推理过程。</p>

<!-- more -->

<h2 id="source">Source</h2>

<p>code source ：https://github.com/Jinyeop3110/KG-R1.</p>

<p>paper source ：https://arxiv.org/abs/2509.26383</p>

<h2 id="摘要">摘要</h2>

<p>知识图谱检索增强生成（KG-RAG）通过将大型语言模型（LLM）与结构化、可验证的知识图谱（KG）相结合，从而减轻模型幻觉问题，并显式呈现其推理过程。然而，许多KG-RAG系统由多个LLM模块（如规划、推理和响应）组成，增加了推理成本，并将推理行为绑定到特定的目标知识图谱上。为此，我们引入了KG-R1，一种基于强化学习（RL）的智能体知识图谱检索增强生成（KGRAG）框架。KG-R1利用一个单智能体与知识图谱进行交互并将知识图谱作为其环境，在每个步骤学习检索，并将检索到的信息合并到KG-R1的推理和生成中。该过程通过端到端的强化学习进行优化。在跨知识图谱问答（KGQA）基准的实验中，证明了方法的有效性和可迁移性：与先前的使用更大的基础模型或微调的模型的多模块工作流方法相比，KG-R1方法使用Qwen-2.5-3B模型，用更少的token取得了更好的准确性。KG-R1支持即插即用，经过训练后，它在其他知识图谱上也能保持很高的准确性，无需再训练。</p>

<h2 id="引言">引言</h2>

<p>典型的KG-RAG采用由四个主要子任务组成的模块化工作流：检索、推理、审查、响应</p>

<p>1、检索以查询KG中的事实</p>

<p>2、推理以处理检索到的信息</p>

<p>3、审查以验证逻辑一致性</p>

<p>4、响应以综合最终答案</p>

<p>存在问题：</p>

<p>1、现有的检索增强生成方法计算成本高：</p>

<p>基于提示的方法通过多次和LLM进行交互，不可避免的导致LLM call、时延和使用token不断累积</p>

<p>2、对其他知识图谱或更新后的知识图谱的可迁移性和可泛化性差：</p>

<p>还有一些基于提示和微调的方法在当前知识图谱中得到了较好的调优结果，当迁移到新的知识图谱时，不能保证性能会完整保留。</p>

<p>KG-R1，一种采用端到端多轮强化学习的智能体KG-RAG系统。</p>

<p>KG-R1的体系结构有两个组件：单个轻量模型作为智能体和知识图谱检索服务器（作为环境）。知识图谱检索服务器托管知识图以及一组检索操作。轻量模型智能体迭代地执行推理和生成步骤，然后执行多轮检索操作，每个决策都基于知识图谱检索服务器获取的知识生成，并获取最终答案。</p>

<h2 id="创新点">创新点</h2>

<p>1、KG-R1框架：引入强化学习使得轻量模型学习到最优的推理策略，使智能体在知识图谱环境中交替进行推理和检索操作得到最终答案。</p>

<p>2、有效的推理过程：KG-R1在使用轻量开源模型和较低的计算成本之下取得了和比较通用模型（如GPT4等）相同甚至更好的效果。</p>

<p>3、即插即用，跨知识图谱可迁移性：经过训练的KG-R 可轻松迁移至各种知识图谱，并保持KG-RAG的良好性能。</p>

<h2 id="kg-r1框架总体概述">KG-R1框架总体概述</h2>

<p>KG-R1将KG-RAG转换为与KG接口（KG检索服务器）的多轮交互。</p>

<p>作者优先考虑两个设计原则。</p>

<p>1、设计了一个单代理体系结构，它可以简化部署并实现高效、低成本的推理。</p>

<p>2、构建了一个与模式无关（schema-agnostic）的知识图谱检索服务器，避免引入针对特定知识图谱的假设，从而在不同的知识图谱之间保持良好的可移植性。</p>

<p>问题</p>

<p>什么是KG-RAG？</p>

<p>什么叫与模式无关？</p>

<p>指系统的设计不依赖某一个特定的 schema 细节，不假设“图里一定有某种具体的实体类型/关系名”，因此可以在不同结构的知识图谱之间复用。</p>

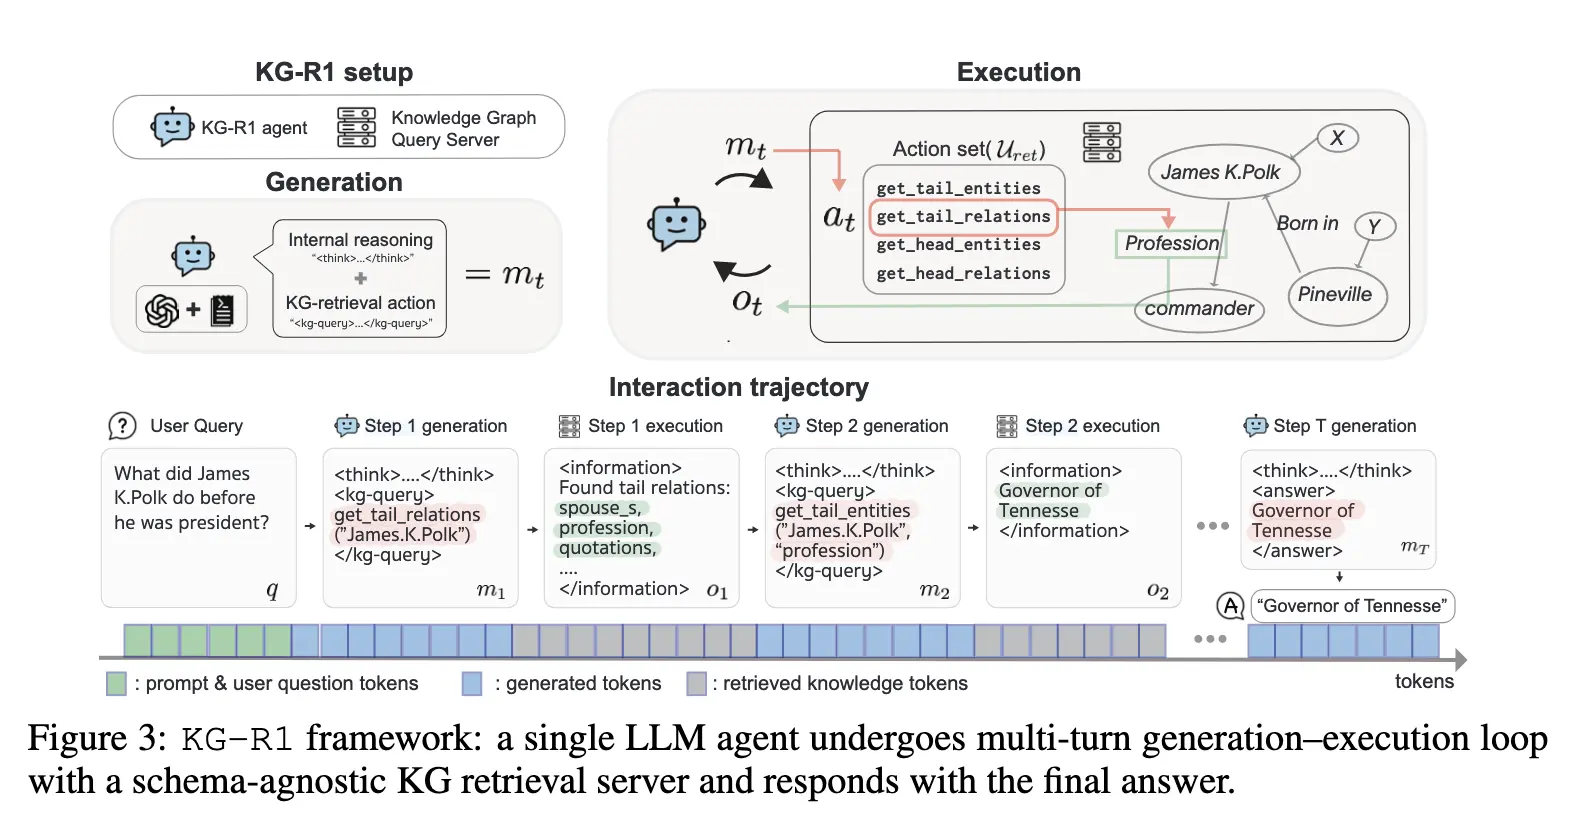
<p>KG-R1 Framework</p>

<p><img src="../images/KG-R1/KG-R1-freamwork.webp" alt="KG-R1-freamwork" /></p>

<p>1、知识图谱检索服务</p>

<p>为知识图谱搭建一个后端检索服务，并提供一个单跳检索操作集接口$U_{ret}$，</p>

<p>2、KG-R1智能体</p>

<p>智能体运行包含两个过程，1、生成过程，2、执行过程</p>

<p>生成阶段</p>

<p>包含两个部分响应，一个是思考过程think，一个是检索执行动作 KG Query或者最终答案Answer。</p>

<p>执行阶段：</p>

<p>使用一个精确匹配解析器，解析生成阶段的响应并映射到知识图谱检索服务的操作集上（也可能是响应错误或者预测结果答案），如果解析是答案交互终止，如果是在操作集中，则会生成一个观察结果用于下一轮交互。</p>

<p>提示词如下</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>You are a helpful assistant. Answer the given question. You can query from knowledge base provided to you to answer the question. You can query knowledge up to <span class="o">[</span>H] times. You must first conduct reasoning inside &lt;think&gt;...&lt;/think&gt;. If you need to query knowledge, you can <span class="nb">set </span>a query statement between &lt;kg-query&gt;...&lt;/kg-query&gt; to query from knowledge base after &lt;think&gt;...&lt;/think&gt;. When you have the final answer, you can output the answer inside &lt;answer&gt;...&lt;/answer&gt;. 
KG Query Server Instruction : <span class="o">[</span>KG query server instruction] 
Question: <span class="o">[</span>question]. 
Assistant:
</code></pre></div></div>

<p>两个可验证的命题：</p>

<p>检索操作集的完整性：对任意推理路径，通过该操作集的检索动作，都可以得到完整的推理路径。</p>

<p>检索操作无约束可迁移性：对于任何其他的后端知识图谱检索任务，该操作集都可以无缝适用。</p>

<h2 id="kg-r1-training-with-rl">KG-R1 Training With RL</h2>

<p>通过使用GRPO强化学习算法微调轻量化开源模型找到一个策略，使得KG-R1 智能体学会通过多轮交互有效检索知识图谱上的推理路径并生成精确的答案。</p>

<p>奖励函数：单轮回合奖励 + 全局结果奖励</p>

<p>回合奖励：</p>

<p><img src="../images/KG-R1/%E5%A5%96%E5%8A%B1%E5%87%BD%E6%95%B01.webp" alt="奖励函数1" /></p>

<p><img src="../images/KG-R1/%E5%A5%96%E5%8A%B1%E5%8F%8A%E4%BC%98%E5%8A%BF%E5%87%BD%E6%95%B0.webp" alt="奖励及优势函数" /></p>

<p>同一批 rollouts 里，谁比平均表现好 → 正优势，差 → 负优势</p>

<p>用 同一个 group 基线，就不需要额外训练一个 value 网络（这就是 GRPO 最大的区别）</p>

<p>把优势分到每一个token：</p>

<p><img src="../images/KG-R1/%E5%B9%B3%E5%9D%87%E5%88%86%E9%85%8Dtoken.webp" alt="平均分配token" /></p>

<p>在第 nnn 条轨迹第 ttt 轮的输出文本中，有一连串 token</p>

<p>只对「agent 生成的部分」（不包括系统 prompt、用户 problem）打梯度</p>

<p>然后把同一个 step 的优势分给该 step 的每个有效 token</p>

<p>本质目的：无论增大还是减小概率，每次更新都别太猛。</p>

<p><img src="../images/KG-R1/%E7%9B%AE%E6%A0%87%E5%87%BD%E6%95%B0.webp" alt="目标函数" /></p>

<p>重要性采样比率：</p>

<p><img src="../images/KG-R1/%E9%87%8D%E8%A6%81%E6%80%A7%E9%87%87%E6%A0%B7%E7%AD%96%E7%95%A5.webp" alt="重要性采样策略" /></p>

<p>KL散度的作用：限制当前策略要偏离参考策略 （通常是初始模型）太远，防止训练发散。</p>

<p>当当前策略和初始策略的比例相差太多时，即使前面的PPO-clip将策略提高太多时，后面的KL散度也可以按照一定的比例进行惩罚。</p>

<p><strong>在每个 token 上做一个 PPO 式的策略梯度更新</strong></p>

<ul>
  <li>用 <strong>group-relative turn-level advantage</strong> 说“这一整轮行为好不好”；</li>
  <li>用 ρ​ 和 clip 控制单步更新强度；</li>
  <li>用 KL 把策略拉回到原始 SFT 模型附近，保证稳定；最后对所有 rollout  回合 token 求和，得到整体的 RL 目标 J(θ)​。</li>
</ul>

<h2 id="实验部分">实验部分</h2>

<p>1、测试KG-R1在KG训练集上训练后的性能和效率</p>

<p>2、测试KG-R1迁移到不同KG到效果</p>

<p>对比基线:</p>

<p>无 KG 方法: Vanilla LLM, Chain-of-Thought (CoT)。</p>

<p>KG-RAG 方法: RoG (微调 LLaMA2-7B), ToG (GPT-3.5), ReKnoS (GPT-4o-mini) 。</p>

<p>训练数据: 在 WebQSP (Freebase子集) 和 CWQ (Complex WebQuestions, 复杂多跳) 上进行训练 。</p>

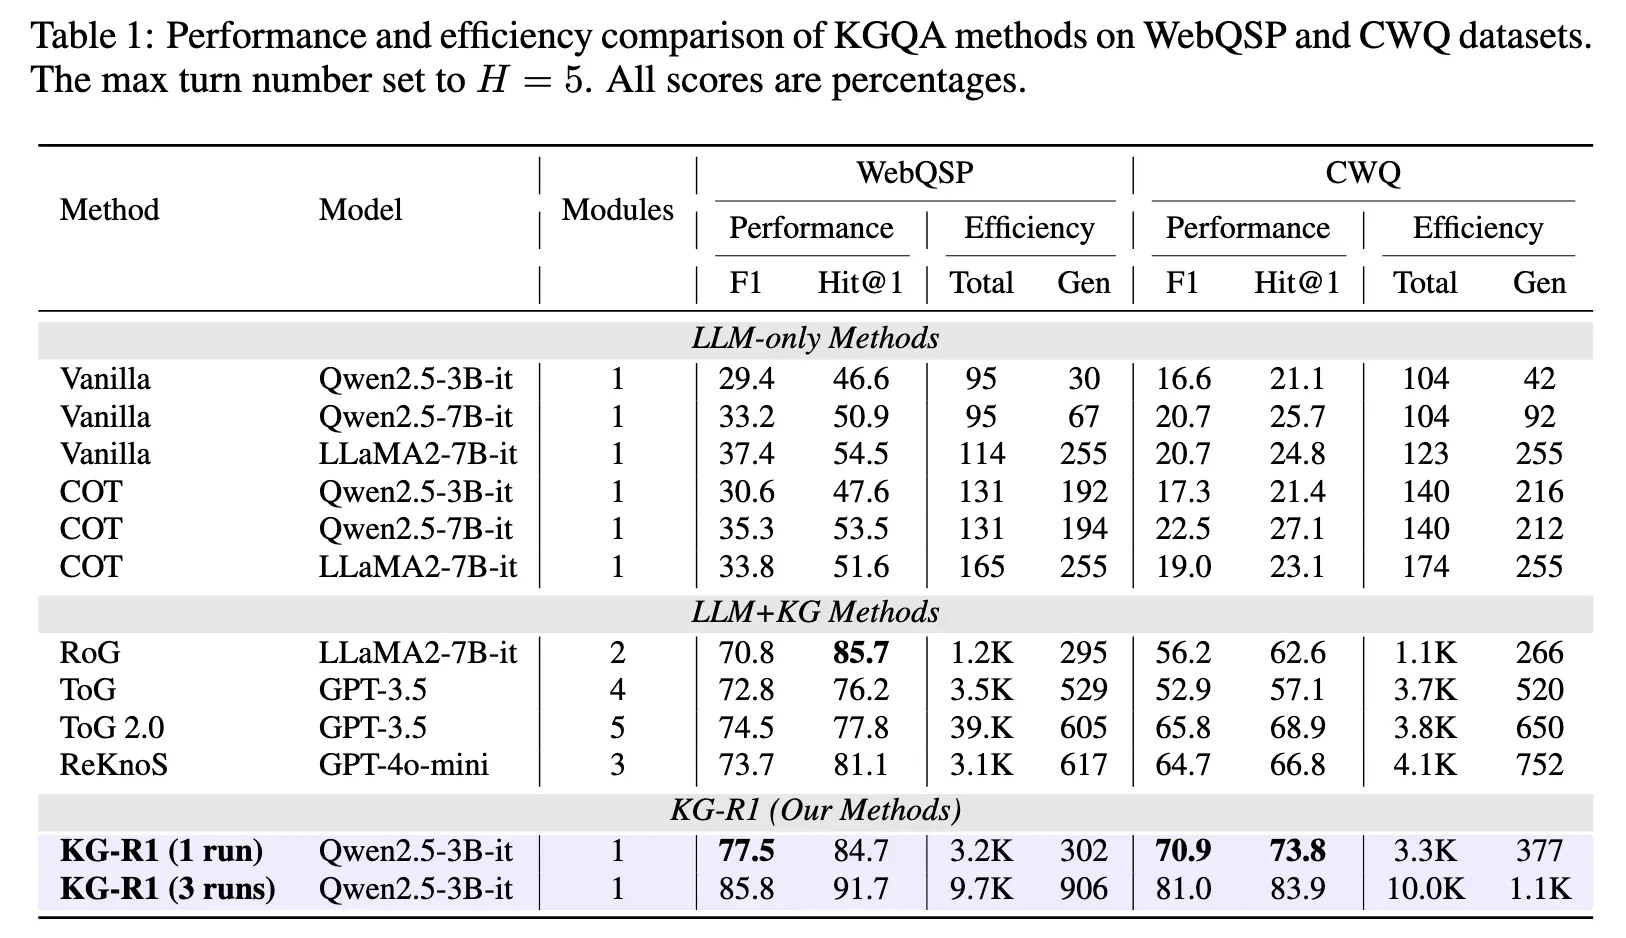
<h3 id="对比实验结果">对比实验结果</h3>

<p><img src="../images/KG-R1/result_comparison.webp" alt="result_comparison" /></p>

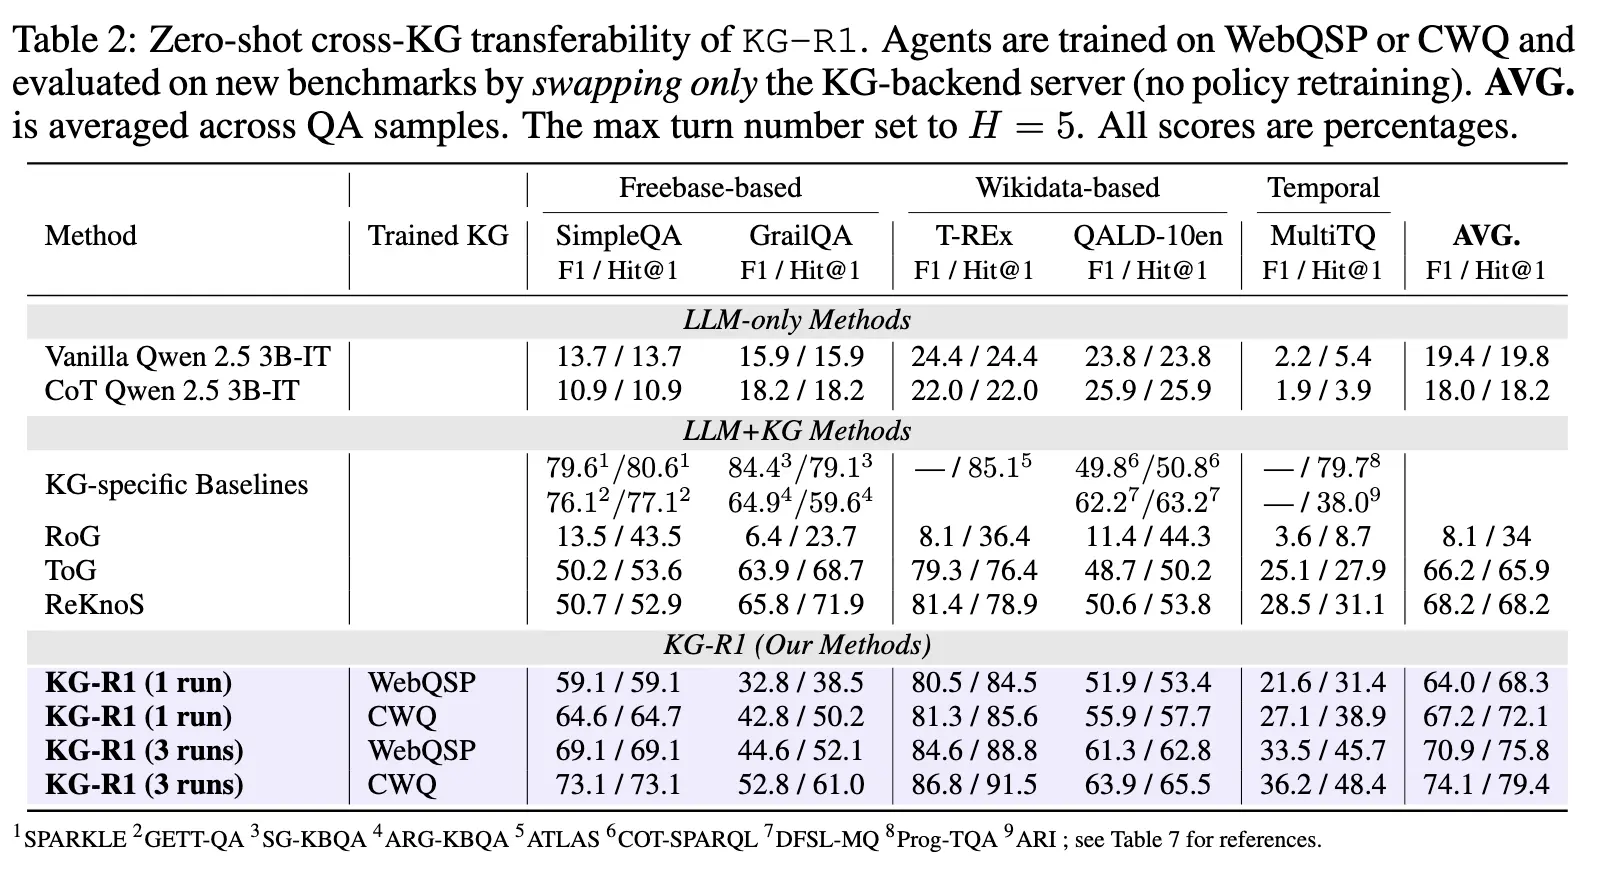
<h3 id="跨图谱迁移实验结果">跨图谱迁移实验结果</h3>

<p>跨图谱迁移能力</p>

<ol>
  <li>直接使用在 WebQSP 或 CWQ 上训练好的 Agent 模型。</li>
  <li>不进行任何微调，直接更换后端的 KG Server 数据源。</li>
  <li>在全新的数据集上进行测试。</li>
</ol>

<p><img src="../images/KG-R1/cross_result.webp" alt="cross_result" /></p>

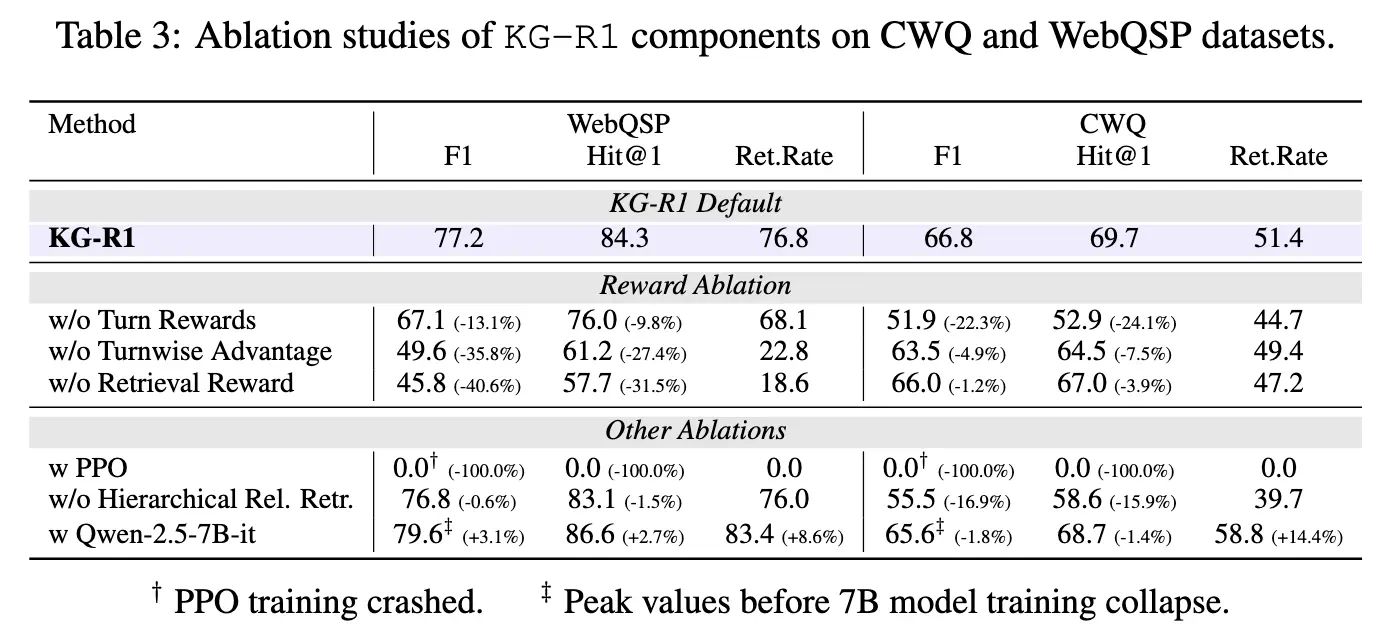
<h3 id="消融实验结果">消融实验结果</h3>

<p><img src="../images/KG-R1/ablation_result.webp" alt="ablation_result" /></p>]]></content><author><name>Xudu</name></author><category term="论文笔记" /><category term="KG-R1" /><category term="RL" /><category term="KG-RAG" /><summary type="html"><![CDATA[知识图谱检索增强生成（KG-RAG）通过将大型语言模型（LLM）与结构化、可验证的知识图谱（KG）相结合，从而减轻模型幻觉问题，并显式呈现其推理过程。]]></summary></entry><entry><title type="html">Related Work：如何组织文献并写好相关工作</title><link href="https://xuduyinuo.cn/how-write-related-work/" rel="alternate" type="text/html" title="Related Work：如何组织文献并写好相关工作" /><published>2025-11-28T20:08:48+08:00</published><updated>2025-11-28T20:08:48+08:00</updated><id>https://xuduyinuo.cn/how-write-related-work</id><content type="html" xml:base="https://xuduyinuo.cn/how-write-related-work/"><![CDATA[<p>从文献筛选到段落组织，梳理渐进叙述、方法归类与对比总结三种写法。围绕“这项研究与我的工作有什么关联”，让相关工作形成清晰的论述。</p>

<!-- more -->

<p>参考链接：https://guidetogradschoolsurvival.wordpress.com/2011/04/08/how-to-write-related-work/</p>

<p>相关工作部分通常在引言之后，有些论文也会放在实验章节后面。相关工作又称为“小综述”，用较短的篇幅介绍与你自己研究有所关联的他人成ß果——可能是你研究的基础，也可能是其他人针对同一问题提出的不同解决方案。</p>

<h2 id="关于如何撰写相关工作部分">关于如何撰写相关工作部分</h2>

<ol>
  <li>将和你的研究相关联的文献按照渐进式叙述或对比总结式表述，每个文献使用两三句话总结关键点进行介绍；</li>
  <li>将你要提及的多个文献整理归类为一个类别进行整体介绍，再在介绍的段落之中插入引用；</li>
  <li>精选最重要的文献，并只讨论这些核心文献。使用一个段落详细介绍该文献的内容，表述和你的研究的关联性；</li>
</ol>

<p>就目前为止，我看的大多数论文还是采用第一种和第二种方法撰写相关工作内容。</p>

<h2 id="表述方式">表述方式</h2>

<p>渐进式叙述</p>

<p>按时间演进进行叙述：例如：在这一领域，早期主要研究什么方法，但是有什么问题；现有的方法集中于什么什么，取得了什么效果，然而……</p>

<p>按方法论分别叙述：根据你的研究内容将相关联的研究方法分为几类，逐个叙述；</p>

<p>对比总结，例如：现有方法A是什么思路，用于什么场景，现有方法B采用了另一种思路，取得了什么效果……</p>

<h2 id="相关工作部分的另一个关键点">相关工作部分的另一个关键点</h2>

<p>如果你决定提及某篇文献，它必须与你的研究有具体、明确的关联。你应该能够（轻松地）为选择的每一篇文献进行辩护，说明选择它的理由及其重要性。有些文献很容易解释——它们是你研究的基础，或者提供了解决同一问题的其他方案。但有些文献则较难论证。如果发现难以解释其关联性，那么你就需要自问：为什么要纳入这篇文献？它是否真的必要？</p>

<h2 id="读论文的建议">读论文的建议</h2>

<p>建立文献笔记：每阅读一篇论文，就写下简短总结并标注其核心部分。这样，在需要判断相关性时，你可以参考自己的笔记摘要，而无需依赖论文原文的摘要。</p>

<p>顺藤摸瓜：利用所读论文的参考文献列表来寻找其他相关文献。如果某篇论文与你的课题紧密相关，那么它引用的文献很可能也高度相关，值得一读。</p>

<p>追踪目标期刊/会议：浏览你计划投稿的期刊或会议的过往发表记录，很可能在其中找到与你主题相关的论文。</p>

<p>明确关联性：在撰写关于某篇文献的段落时，确保你能回答”这项研究如何与我的工作相关联？”这个问题。如果你回答不了，那就需要考虑是否真的有必要将其纳入。</p>

<p>最后记录一下今天看见的名言：见人皆所见，思人所未思。</p>]]></content><author><name>Xudu</name></author><category term="论文笔记" /><category term="thought" /><category term="blog" /><category term="related work" /><summary type="html"><![CDATA[从文献筛选到段落组织，梳理渐进叙述、方法归类与对比总结三种写法。围绕“这项研究与我的工作有什么关联”，让相关工作形成清晰的论述。]]></summary></entry><entry><title type="html">十大经典排序算法</title><link href="https://xuduyinuo.cn/sort-algorithm/" rel="alternate" type="text/html" title="十大经典排序算法" /><published>2025-11-22T17:59:14+08:00</published><updated>2025-11-22T17:59:14+08:00</updated><id>https://xuduyinuo.cn/sort-algorithm</id><content type="html" xml:base="https://xuduyinuo.cn/sort-algorithm/"><![CDATA[<p>排序算法</p>

<!-- more -->

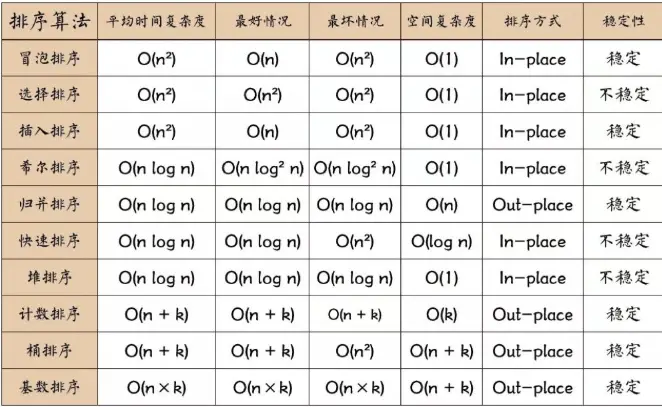
<p><img src="../images/sort-algorithm/sort.webp" alt="sort_algorithm" /></p>

<h2 id="冒泡排序">冒泡排序</h2>

<p>比较相邻元素，如果顺序不对就交换，每一轮都找到一个最大/最小的数移动到末尾或开头</p>

<p>重复完成剩余的待排序元素</p>

<p>代码详解：</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="cm">/**
 * 冒泡排序
 */</span>
<span class="kd">public</span> <span class="kd">class</span> <span class="nc">BubbleSort</span> <span class="kd">implements</span> <span class="nc">IArraySort</span><span class="o">{</span>
    <span class="nd">@Override</span>
    <span class="kd">public</span> <span class="kt">int</span><span class="o">[]</span> <span class="nf">sort</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">sourceArray</span><span class="o">)</span> <span class="o">{</span>
        <span class="c1">//拷贝原数组</span>
        <span class="kt">int</span><span class="o">[]</span> <span class="n">arr</span> <span class="o">=</span> <span class="nc">Arrays</span><span class="o">.</span><span class="na">copyOf</span><span class="o">(</span><span class="n">sourceArray</span><span class="o">,</span> <span class="n">sourceArray</span><span class="o">.</span><span class="na">length</span><span class="o">);</span>

        <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">i</span> <span class="o">=</span> <span class="mi">0</span><span class="o">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="n">arr</span><span class="o">.</span><span class="na">length</span> <span class="o">-</span> <span class="mi">1</span><span class="o">;</span> <span class="n">i</span><span class="o">++)</span> <span class="o">{</span>

            <span class="c1">// 提前结束标志位</span>
            <span class="kt">boolean</span> <span class="n">flag</span> <span class="o">=</span> <span class="kc">false</span><span class="o">;</span>

            <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">j</span> <span class="o">=</span> <span class="mi">0</span><span class="o">;</span> <span class="n">j</span> <span class="o">&lt;</span> <span class="n">arr</span><span class="o">.</span><span class="na">length</span> <span class="o">-</span> <span class="n">i</span> <span class="o">-</span> <span class="mi">1</span><span class="o">;</span> <span class="n">j</span><span class="o">++)</span> <span class="o">{</span>
                <span class="k">if</span> <span class="o">(</span><span class="n">arr</span><span class="o">[</span><span class="n">j</span><span class="o">]</span> <span class="o">&gt;</span> <span class="n">arr</span><span class="o">[</span><span class="n">j</span> <span class="o">+</span> <span class="mi">1</span><span class="o">])</span> <span class="o">{</span>
                    <span class="n">swap</span><span class="o">(</span><span class="n">arr</span><span class="o">,</span> <span class="n">j</span><span class="o">,</span> <span class="n">j</span> <span class="o">+</span> <span class="mi">1</span><span class="o">);</span>
                    <span class="n">flag</span> <span class="o">=</span> <span class="kc">true</span><span class="o">;</span>
                <span class="o">}</span>
            <span class="o">}</span>

            <span class="c1">// 提前结束</span>
            <span class="k">if</span> <span class="o">(!</span><span class="n">flag</span><span class="o">)</span> <span class="o">{</span>
                <span class="k">break</span><span class="o">;</span>
            <span class="o">}</span>
        <span class="o">}</span>

        <span class="k">return</span> <span class="n">arr</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="cm">/**
     *交换数组中的两个元素
     */</span>
    <span class="kd">private</span> <span class="kt">void</span> <span class="nf">swap</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">arr</span><span class="o">,</span> <span class="kt">int</span> <span class="n">i</span><span class="o">,</span> <span class="kt">int</span> <span class="n">j</span><span class="o">)</span> <span class="o">{</span>
        <span class="kt">int</span> <span class="n">temp</span> <span class="o">=</span> <span class="n">arr</span><span class="o">[</span><span class="n">i</span><span class="o">];</span>
        <span class="n">arr</span><span class="o">[</span><span class="n">i</span><span class="o">]</span> <span class="o">=</span> <span class="n">arr</span><span class="o">[</span><span class="n">j</span><span class="o">];</span>
        <span class="n">arr</span><span class="o">[</span><span class="n">j</span><span class="o">]</span> <span class="o">=</span> <span class="n">temp</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>

</code></pre></div></div>

<h2 id="选择排序">选择排序</h2>

<p>遍历数组，从数组找到一个最小/最大的数，放在开头或末尾</p>

<p>对剩余待排序数组重复以上操作直至数组有序</p>

<p>代码详解：</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="cm">/**
 * 选择排序
 */</span>
<span class="kd">public</span> <span class="kd">class</span> <span class="nc">SelectionSort</span> <span class="kd">implements</span> <span class="nc">IArraySort</span><span class="o">{</span>
    <span class="nd">@Override</span>
    <span class="kd">public</span> <span class="kt">int</span><span class="o">[]</span> <span class="nf">sort</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">sourceArray</span><span class="o">)</span> <span class="o">{</span>

        <span class="kt">int</span><span class="o">[]</span> <span class="n">arr</span> <span class="o">=</span> <span class="nc">Arrays</span><span class="o">.</span><span class="na">copyOf</span><span class="o">(</span><span class="n">sourceArray</span><span class="o">,</span> <span class="n">sourceArray</span><span class="o">.</span><span class="na">length</span><span class="o">);</span>

        <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">i</span> <span class="o">=</span> <span class="mi">0</span><span class="o">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="n">arr</span><span class="o">.</span><span class="na">length</span> <span class="o">-</span> <span class="mi">1</span><span class="o">;</span> <span class="n">i</span><span class="o">++)</span> <span class="o">{</span>
            <span class="c1">// 寻找当前索引之后的最小值</span>
            <span class="kt">int</span> <span class="n">minIndex</span> <span class="o">=</span> <span class="n">i</span><span class="o">;</span>

            <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">j</span> <span class="o">=</span> <span class="n">i</span> <span class="o">+</span> <span class="mi">1</span><span class="o">;</span> <span class="n">j</span> <span class="o">&lt;</span> <span class="n">arr</span><span class="o">.</span><span class="na">length</span><span class="o">;</span> <span class="n">j</span><span class="o">++)</span> <span class="o">{</span>
                <span class="k">if</span> <span class="o">(</span><span class="n">arr</span><span class="o">[</span><span class="n">j</span><span class="o">]</span> <span class="o">&lt;</span> <span class="n">arr</span><span class="o">[</span><span class="n">minIndex</span><span class="o">])</span> <span class="o">{</span>
                    <span class="n">minIndex</span> <span class="o">=</span> <span class="n">j</span><span class="o">;</span>
                <span class="o">}</span>
            <span class="o">}</span>

            <span class="c1">// 如果最小值不是当前值，则交换</span>
            <span class="k">if</span> <span class="o">(</span><span class="n">minIndex</span> <span class="o">!=</span> <span class="n">i</span><span class="o">)</span> <span class="o">{</span>
                <span class="n">swap</span><span class="o">(</span><span class="n">arr</span><span class="o">,</span> <span class="n">i</span><span class="o">,</span> <span class="n">minIndex</span><span class="o">);</span>
            <span class="o">}</span>
        <span class="o">}</span>
        <span class="k">return</span> <span class="n">arr</span><span class="o">;</span>
    <span class="o">}</span>


    <span class="cm">/**
     *交换数组中的两个元素
     */</span>
    <span class="kd">private</span> <span class="kt">void</span> <span class="nf">swap</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">arr</span><span class="o">,</span> <span class="kt">int</span> <span class="n">i</span><span class="o">,</span> <span class="kt">int</span> <span class="n">j</span><span class="o">)</span> <span class="o">{</span>
        <span class="kt">int</span> <span class="n">temp</span> <span class="o">=</span> <span class="n">arr</span><span class="o">[</span><span class="n">i</span><span class="o">];</span>
        <span class="n">arr</span><span class="o">[</span><span class="n">i</span><span class="o">]</span> <span class="o">=</span> <span class="n">arr</span><span class="o">[</span><span class="n">j</span><span class="o">];</span>
        <span class="n">arr</span><span class="o">[</span><span class="n">j</span><span class="o">]</span> <span class="o">=</span> <span class="n">temp</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>

</code></pre></div></div>

<h2 id="插入排序">插入排序</h2>

<p>将待排序的元素逐个插入到已经排序的序列中的合适位置，直到整个序列都排好序为止。</p>

<p>代码详解：</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="cm">/**
 * 插入排序
 */</span>
<span class="kd">public</span> <span class="kd">class</span> <span class="nc">InsertSort</span> <span class="kd">implements</span> <span class="nc">IArraySort</span> <span class="o">{</span>
    <span class="nd">@Override</span>
    <span class="kd">public</span> <span class="kt">int</span><span class="o">[]</span> <span class="nf">sort</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">sourceArray</span><span class="o">)</span> <span class="o">{</span>

        <span class="kt">int</span><span class="o">[]</span> <span class="n">arr</span> <span class="o">=</span> <span class="nc">Arrays</span><span class="o">.</span><span class="na">copyOf</span><span class="o">(</span><span class="n">sourceArray</span><span class="o">,</span> <span class="n">sourceArray</span><span class="o">.</span><span class="na">length</span><span class="o">);</span>
        <span class="c1">// 插入排序</span>
        <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">i</span> <span class="o">=</span> <span class="mi">1</span><span class="o">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="n">arr</span><span class="o">.</span><span class="na">length</span><span class="o">;</span> <span class="n">i</span><span class="o">++)</span> <span class="o">{</span>
            <span class="kt">int</span> <span class="n">temp</span> <span class="o">=</span> <span class="n">arr</span><span class="o">[</span><span class="n">i</span><span class="o">];</span>
            <span class="kt">int</span> <span class="n">j</span> <span class="o">=</span> <span class="n">i</span><span class="o">;</span>
            <span class="k">while</span> <span class="o">(</span><span class="n">j</span> <span class="o">&gt;</span> <span class="mi">0</span> <span class="o">&amp;&amp;</span> <span class="n">arr</span><span class="o">[</span><span class="n">j</span> <span class="o">-</span> <span class="mi">1</span><span class="o">]</span> <span class="o">&gt;</span> <span class="n">temp</span><span class="o">)</span> <span class="o">{</span>
                <span class="n">arr</span><span class="o">[</span><span class="n">j</span><span class="o">]</span> <span class="o">=</span> <span class="n">arr</span><span class="o">[</span><span class="n">j</span> <span class="o">-</span> <span class="mi">1</span><span class="o">];</span>
                <span class="n">j</span><span class="o">--;</span>
            <span class="o">}</span>
            <span class="k">if</span> <span class="o">(</span><span class="n">j</span> <span class="o">!=</span> <span class="n">i</span><span class="o">){</span>
                <span class="n">arr</span><span class="o">[</span><span class="n">j</span><span class="o">]</span> <span class="o">=</span> <span class="n">temp</span><span class="o">;</span>
            <span class="o">}</span>
        <span class="o">}</span>

        <span class="k">return</span> <span class="n">arr</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<h2 id="希尔排序">希尔排序</h2>

<p>将整个待排序的记录序列分割成为若干子序列分别进行直接插入排序，待整个序列中的记录”基本有序”时，再对全体记录进行依次直接插入排序。</p>

<p>代码详解：</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="cm">/**
 * 希尔排序
 */</span>
<span class="kd">public</span> <span class="kd">class</span> <span class="nc">ShellSort</span> <span class="kd">implements</span> <span class="nc">IArraySort</span><span class="o">{</span>
    <span class="nd">@Override</span>
    <span class="kd">public</span> <span class="kt">int</span><span class="o">[]</span> <span class="nf">sort</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">sourceArray</span><span class="o">)</span> <span class="o">{</span>
        <span class="n">shellSort</span><span class="o">(</span><span class="n">sourceArray</span><span class="o">);</span>
        <span class="k">return</span> <span class="n">sourceArray</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="kd">private</span> <span class="kt">void</span> <span class="nf">shellSort</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">sourceArray</span><span class="o">)</span> <span class="o">{</span>
        <span class="kt">int</span> <span class="n">n</span> <span class="o">=</span> <span class="n">sourceArray</span><span class="o">.</span><span class="na">length</span><span class="o">;</span>
        <span class="kt">int</span> <span class="n">gap</span> <span class="o">=</span> <span class="n">n</span> <span class="o">/</span> <span class="mi">2</span><span class="o">;</span>
        <span class="k">while</span> <span class="o">(</span><span class="n">gap</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="o">)</span> <span class="o">{</span>
            <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">i</span> <span class="o">=</span> <span class="n">gap</span><span class="o">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="n">n</span><span class="o">;</span> <span class="n">i</span><span class="o">++)</span> <span class="o">{</span>
                <span class="kt">int</span> <span class="n">temp</span> <span class="o">=</span> <span class="n">sourceArray</span><span class="o">[</span><span class="n">i</span><span class="o">];</span>
                <span class="kt">int</span> <span class="n">j</span> <span class="o">=</span> <span class="n">i</span> <span class="o">-</span> <span class="n">gap</span><span class="o">;</span>
                <span class="k">while</span> <span class="o">(</span><span class="n">j</span> <span class="o">&gt;=</span> <span class="mi">0</span> <span class="o">&amp;&amp;</span> <span class="n">sourceArray</span><span class="o">[</span><span class="n">j</span><span class="o">]</span> <span class="o">&gt;</span> <span class="n">temp</span><span class="o">)</span> <span class="o">{</span>
                    <span class="n">sourceArray</span><span class="o">[</span><span class="n">j</span> <span class="o">+</span> <span class="n">gap</span><span class="o">]</span> <span class="o">=</span> <span class="n">sourceArray</span><span class="o">[</span><span class="n">j</span><span class="o">];</span>
                    <span class="n">j</span> <span class="o">-=</span> <span class="n">gap</span><span class="o">;</span>
                <span class="o">}</span>
                <span class="n">sourceArray</span><span class="o">[</span><span class="n">j</span> <span class="o">+</span> <span class="n">gap</span><span class="o">]</span> <span class="o">=</span> <span class="n">temp</span><span class="o">;</span>
            <span class="o">}</span>
            <span class="n">gap</span> <span class="o">/=</span> <span class="mi">2</span><span class="o">;</span>
        <span class="o">}</span>
    <span class="o">}</span>
<span class="o">}</span>

</code></pre></div></div>

<h2 id="归并排序">归并排序</h2>

<p>将一个待排序的序列分成两个子序列，分别对两个子序列进行排序，然后将两个已排序的子序列合并成一个有序序列。</p>

<h3 id="递归版本">递归版本</h3>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="cm">/**
 * 归并排序
 */</span>
<span class="kd">public</span> <span class="kd">class</span> <span class="nc">MergeSort</span> <span class="kd">implements</span> <span class="nc">IArraySort</span><span class="o">{</span>

    <span class="kd">public</span> <span class="kd">static</span> <span class="kt">int</span> <span class="no">MAXN</span> <span class="o">=</span> <span class="mi">100001</span><span class="o">;</span>

    <span class="c1">// 辅助数组</span>
    <span class="kd">public</span> <span class="kd">static</span> <span class="kt">int</span><span class="o">[]</span> <span class="n">help</span> <span class="o">=</span> <span class="k">new</span> <span class="kt">int</span><span class="o">[</span><span class="no">MAXN</span><span class="o">];</span>

    <span class="nd">@Override</span>
    <span class="kd">public</span> <span class="kt">int</span><span class="o">[]</span> <span class="nf">sort</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">sourceArray</span><span class="o">)</span> <span class="o">{</span>
        <span class="kt">int</span><span class="o">[]</span> <span class="n">arr</span> <span class="o">=</span> <span class="nc">Arrays</span><span class="o">.</span><span class="na">copyOf</span><span class="o">(</span><span class="n">sourceArray</span><span class="o">,</span> <span class="n">sourceArray</span><span class="o">.</span><span class="na">length</span><span class="o">);</span>
        <span class="n">mergeSort</span><span class="o">(</span><span class="n">arr</span><span class="o">,</span> <span class="mi">0</span><span class="o">,</span> <span class="n">arr</span><span class="o">.</span><span class="na">length</span> <span class="o">-</span> <span class="mi">1</span><span class="o">);</span>
        <span class="k">return</span> <span class="n">arr</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="cm">/**
     * 递归归并排序
     */</span>
    <span class="kd">private</span> <span class="kt">void</span> <span class="nf">mergeSort</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">sourceArray</span><span class="o">,</span> <span class="kt">int</span> <span class="n">left</span><span class="o">,</span> <span class="kt">int</span> <span class="n">right</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">if</span> <span class="o">(</span><span class="n">left</span> <span class="o">&gt;=</span> <span class="n">right</span><span class="o">)</span> <span class="o">{</span>
            <span class="k">return</span><span class="o">;</span>
        <span class="o">}</span>
        <span class="kt">int</span> <span class="n">mid</span> <span class="o">=</span> <span class="n">left</span> <span class="o">+</span> <span class="o">(</span><span class="n">right</span> <span class="o">-</span> <span class="n">left</span><span class="o">)</span> <span class="o">/</span> <span class="mi">2</span><span class="o">;</span>
        <span class="n">mergeSort</span><span class="o">(</span><span class="n">sourceArray</span><span class="o">,</span> <span class="n">left</span><span class="o">,</span> <span class="n">mid</span><span class="o">);</span>
        <span class="n">mergeSort</span><span class="o">(</span><span class="n">sourceArray</span><span class="o">,</span> <span class="n">mid</span> <span class="o">+</span> <span class="mi">1</span><span class="o">,</span> <span class="n">right</span><span class="o">);</span>
        <span class="n">merge</span><span class="o">(</span><span class="n">sourceArray</span><span class="o">,</span> <span class="n">left</span><span class="o">,</span> <span class="n">mid</span><span class="o">,</span> <span class="n">right</span><span class="o">);</span>
    <span class="o">}</span>

    <span class="cm">/**
     * 合并两个有序数组
     */</span>
    <span class="kd">private</span> <span class="kt">void</span> <span class="nf">merge</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">sourceArray</span><span class="o">,</span> <span class="kt">int</span> <span class="n">left</span><span class="o">,</span> <span class="kt">int</span> <span class="n">mid</span><span class="o">,</span> <span class="kt">int</span> <span class="n">right</span><span class="o">)</span> <span class="o">{</span>

        <span class="kt">int</span> <span class="n">i</span> <span class="o">=</span> <span class="n">left</span><span class="o">;</span>
        <span class="kt">int</span> <span class="n">a</span> <span class="o">=</span> <span class="n">left</span><span class="o">;</span>
        <span class="kt">int</span> <span class="n">b</span> <span class="o">=</span> <span class="n">mid</span> <span class="o">+</span> <span class="mi">1</span><span class="o">;</span>
        <span class="k">while</span> <span class="o">(</span><span class="n">a</span> <span class="o">&lt;=</span> <span class="n">mid</span> <span class="o">&amp;&amp;</span> <span class="n">b</span> <span class="o">&lt;=</span> <span class="n">right</span><span class="o">)</span> <span class="o">{</span>
            <span class="n">help</span><span class="o">[</span><span class="n">i</span><span class="o">++]</span> <span class="o">=</span> <span class="n">sourceArray</span><span class="o">[</span><span class="n">a</span><span class="o">]</span> <span class="o">&lt;=</span> <span class="n">sourceArray</span><span class="o">[</span><span class="n">b</span><span class="o">]</span> <span class="o">?</span> <span class="n">sourceArray</span><span class="o">[</span><span class="n">a</span><span class="o">++]</span> <span class="o">:</span> <span class="n">sourceArray</span><span class="o">[</span><span class="n">b</span><span class="o">++];</span>
        <span class="o">}</span>
        <span class="c1">// 左侧指针、右侧指针，必有一个越界、另一个不越界</span>
        <span class="k">while</span> <span class="o">(</span><span class="n">a</span> <span class="o">&lt;=</span> <span class="n">mid</span><span class="o">)</span> <span class="o">{</span>
            <span class="n">help</span><span class="o">[</span><span class="n">i</span><span class="o">++]</span> <span class="o">=</span> <span class="n">sourceArray</span><span class="o">[</span><span class="n">a</span><span class="o">++];</span>
        <span class="o">}</span>
        <span class="k">while</span> <span class="o">(</span><span class="n">b</span> <span class="o">&lt;=</span> <span class="n">right</span><span class="o">)</span> <span class="o">{</span>
            <span class="n">help</span><span class="o">[</span><span class="n">i</span><span class="o">++]</span> <span class="o">=</span> <span class="n">sourceArray</span><span class="o">[</span><span class="n">b</span><span class="o">++];</span>
        <span class="o">}</span>
        <span class="k">for</span> <span class="o">(</span><span class="n">i</span> <span class="o">=</span> <span class="n">left</span><span class="o">;</span> <span class="n">i</span> <span class="o">&lt;=</span> <span class="n">right</span><span class="o">;</span> <span class="n">i</span><span class="o">++)</span> <span class="o">{</span>
            <span class="n">sourceArray</span><span class="o">[</span><span class="n">i</span><span class="o">]</span> <span class="o">=</span> <span class="n">help</span><span class="o">[</span><span class="n">i</span><span class="o">];</span>
        <span class="o">}</span>
    <span class="o">}</span>
<span class="o">}</span>

</code></pre></div></div>

<h3 id="非递归版本">非递归版本</h3>

<p>待续……</p>

<h2 id="快速排序">快速排序</h2>

<p>选择一个基准元素，将数组分成两个子数组</p>

<p>使得左边元素都小于基准，右边元素都大于基准</p>

<p>对左右子数组递归地进行快速排序</p>

<p>代码详解：</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="cm">/**
 * 快速排序
 */</span>
<span class="kd">public</span> <span class="kd">class</span> <span class="nc">QuickSort</span> <span class="kd">implements</span> <span class="nc">IArraySort</span><span class="o">{</span>
    <span class="nd">@Override</span>
    <span class="kd">public</span> <span class="kt">int</span><span class="o">[]</span> <span class="nf">sort</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">sourceArray</span><span class="o">)</span> <span class="o">{</span>
        <span class="n">quickSort</span><span class="o">(</span><span class="n">sourceArray</span><span class="o">,</span> <span class="mi">0</span><span class="o">,</span> <span class="n">sourceArray</span><span class="o">.</span><span class="na">length</span> <span class="o">-</span> <span class="mi">1</span><span class="o">);</span>
        <span class="k">return</span> <span class="n">sourceArray</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="cm">/**
     * 快速排序（递归）
     */</span>
    <span class="kd">private</span> <span class="kt">void</span> <span class="nf">quickSort</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">sourceArray</span><span class="o">,</span> <span class="kt">int</span> <span class="n">left</span><span class="o">,</span> <span class="kt">int</span> <span class="n">right</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">if</span> <span class="o">(</span><span class="n">left</span> <span class="o">&lt;</span> <span class="n">right</span><span class="o">){</span>
            <span class="kt">int</span> <span class="n">pivot</span> <span class="o">=</span> <span class="n">partition</span><span class="o">(</span><span class="n">sourceArray</span><span class="o">,</span> <span class="n">left</span><span class="o">,</span> <span class="n">right</span><span class="o">);</span>
            <span class="n">quickSort</span><span class="o">(</span><span class="n">sourceArray</span><span class="o">,</span> <span class="n">left</span><span class="o">,</span> <span class="n">pivot</span> <span class="o">-</span> <span class="mi">1</span><span class="o">);</span>
            <span class="n">quickSort</span><span class="o">(</span><span class="n">sourceArray</span><span class="o">,</span> <span class="n">pivot</span> <span class="o">+</span> <span class="mi">1</span><span class="o">,</span> <span class="n">right</span><span class="o">);</span>

        <span class="o">}</span>
    <span class="o">}</span>

    <span class="cm">/**
     * 分区（排序）
     */</span>
    <span class="kd">private</span> <span class="kt">int</span> <span class="nf">partition</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">sourceArray</span><span class="o">,</span> <span class="kt">int</span> <span class="n">left</span><span class="o">,</span> <span class="kt">int</span> <span class="n">right</span><span class="o">)</span> <span class="o">{</span>
        <span class="kt">int</span> <span class="n">pivot</span> <span class="o">=</span> <span class="n">sourceArray</span><span class="o">[</span><span class="n">left</span><span class="o">];</span>
        <span class="kt">int</span> <span class="n">index</span> <span class="o">=</span> <span class="n">left</span> <span class="o">+</span> <span class="mi">1</span><span class="o">;</span>
        <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">i</span> <span class="o">=</span> <span class="n">index</span><span class="o">;</span> <span class="n">i</span> <span class="o">&lt;=</span> <span class="n">right</span><span class="o">;</span> <span class="n">i</span><span class="o">++)</span> <span class="o">{</span>
            <span class="k">if</span> <span class="o">(</span><span class="n">sourceArray</span><span class="o">[</span><span class="n">i</span><span class="o">]</span> <span class="o">&lt;</span> <span class="n">pivot</span><span class="o">)</span> <span class="o">{</span>
                <span class="n">swap</span><span class="o">(</span><span class="n">sourceArray</span><span class="o">,</span> <span class="n">i</span><span class="o">,</span> <span class="n">index</span><span class="o">);</span>
                <span class="n">index</span><span class="o">++;</span>
            <span class="o">}</span>
        <span class="o">}</span>
        <span class="n">swap</span><span class="o">(</span><span class="n">sourceArray</span><span class="o">,</span> <span class="n">left</span><span class="o">,</span> <span class="n">index</span> <span class="o">-</span> <span class="mi">1</span><span class="o">);</span>
        <span class="k">return</span> <span class="n">index</span> <span class="o">-</span> <span class="mi">1</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="kd">private</span> <span class="kt">void</span> <span class="nf">swap</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">sourceArray</span><span class="o">,</span> <span class="kt">int</span> <span class="n">a</span><span class="o">,</span> <span class="kt">int</span> <span class="n">b</span><span class="o">)</span> <span class="o">{</span>
        <span class="kt">int</span> <span class="n">temp</span> <span class="o">=</span> <span class="n">sourceArray</span><span class="o">[</span><span class="n">a</span><span class="o">];</span>
        <span class="n">sourceArray</span><span class="o">[</span><span class="n">a</span><span class="o">]</span> <span class="o">=</span> <span class="n">sourceArray</span><span class="o">[</span><span class="n">b</span><span class="o">];</span>
        <span class="n">sourceArray</span><span class="o">[</span><span class="n">b</span><span class="o">]</span> <span class="o">=</span> <span class="n">temp</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>

</code></pre></div></div>

<h2 id="计数排序">计数排序</h2>

<p>建立一个计数器辅助数组，大小为待排序数组中的最大值+1，统计原数组中每个元素 i 出现的次数，存入计数器数组中的第 i 项。</p>

<p>将计数器数组中大于0的元素反向填充到原数组中。</p>

<p>代码详解：</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="cm">/**
 * 计数排序
 */</span>
<span class="kd">public</span> <span class="kd">class</span> <span class="nc">CountingSort</span> <span class="kd">implements</span> <span class="nc">IArraySort</span><span class="o">{</span>
    <span class="nd">@Override</span>
    <span class="kd">public</span> <span class="kt">int</span><span class="o">[]</span> <span class="nf">sort</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">sourceArray</span><span class="o">)</span> <span class="o">{</span>
        <span class="n">countingSort</span><span class="o">(</span><span class="n">sourceArray</span><span class="o">);</span>
        <span class="k">return</span> <span class="n">sourceArray</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="kd">private</span> <span class="kt">void</span> <span class="nf">countingSort</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">sourceArray</span><span class="o">)</span> <span class="o">{</span>
        <span class="kt">int</span> <span class="n">maxValue</span> <span class="o">=</span> <span class="n">getMaxValue</span><span class="o">(</span><span class="n">sourceArray</span><span class="o">);</span>

        <span class="c1">// 创建计数数组</span>
        <span class="kt">int</span><span class="o">[]</span> <span class="n">countArray</span> <span class="o">=</span> <span class="k">new</span> <span class="kt">int</span><span class="o">[</span><span class="n">maxValue</span> <span class="o">+</span> <span class="mi">1</span><span class="o">];</span>
        <span class="c1">// 填充计数数组</span>
        <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">value</span> <span class="o">:</span> <span class="n">sourceArray</span><span class="o">)</span> <span class="o">{</span>
            <span class="n">countArray</span><span class="o">[</span><span class="n">value</span><span class="o">]++;</span>
        <span class="o">}</span>
        <span class="c1">// 填充原数组</span>
        <span class="kt">int</span> <span class="n">index</span> <span class="o">=</span> <span class="mi">0</span><span class="o">;</span>
        <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">i</span> <span class="o">=</span> <span class="mi">0</span><span class="o">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="n">countArray</span><span class="o">.</span><span class="na">length</span><span class="o">;</span> <span class="n">i</span><span class="o">++)</span> <span class="o">{</span>
            <span class="k">while</span> <span class="o">(</span><span class="n">countArray</span><span class="o">[</span><span class="n">i</span><span class="o">]</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="o">)</span> <span class="o">{</span>
                <span class="n">sourceArray</span><span class="o">[</span><span class="n">index</span><span class="o">++]</span> <span class="o">=</span> <span class="n">i</span><span class="o">;</span>
                <span class="n">countArray</span><span class="o">[</span><span class="n">i</span><span class="o">]--;</span>
            <span class="o">}</span>
        <span class="o">}</span>
    <span class="o">}</span>

    <span class="c1">// 获取数组中的最大值</span>
    <span class="kd">private</span> <span class="kt">int</span> <span class="nf">getMaxValue</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">sourceArray</span><span class="o">)</span> <span class="o">{</span>
        <span class="kt">int</span> <span class="n">maxValue</span> <span class="o">=</span> <span class="n">sourceArray</span><span class="o">[</span><span class="mi">0</span><span class="o">];</span>
        <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">value</span> <span class="o">:</span> <span class="n">sourceArray</span><span class="o">)</span> <span class="o">{</span>
            <span class="k">if</span> <span class="o">(</span><span class="n">maxValue</span> <span class="o">&lt;</span> <span class="n">value</span><span class="o">)</span> <span class="o">{</span>
                <span class="n">maxValue</span> <span class="o">=</span> <span class="n">value</span><span class="o">;</span>
            <span class="o">}</span>
        <span class="o">}</span>
        <span class="k">return</span> <span class="n">maxValue</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>

</code></pre></div></div>

<h2 id="堆排序">堆排序</h2>

<p>堆排序（Heapsort）是指利用堆这种数据结构所设计的一种排序算法。堆积是一个近似完全二叉树的结构，并同时满足堆积的性质：即子结点的键值或索引总是小于（或者大于）它的父节点。堆排序可以说是一种利用堆的概念来排序的选择排序。分为两种方法：大顶堆：每个节点的值都大于或等于其子节点的值，在堆排序算法中用于升序排列；小顶堆：每个节点的值都小于或等于其子节点的值，在堆排序算法中用于降序排列。</p>
<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="cm">/**
 * @ClassName HeapSort
 * @Description
 * @Author xudu
 * @Time 2026/1/4 21:06
 */</span>
<span class="kd">public</span> <span class="kd">class</span> <span class="nc">HeapSort</span> <span class="kd">implements</span> <span class="nc">IArraySort</span><span class="o">{</span>
    <span class="nd">@Override</span>
    <span class="kd">public</span> <span class="kt">int</span><span class="o">[]</span> <span class="nf">sort</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">sourceArray</span><span class="o">)</span> <span class="o">{</span>
        <span class="c1">// 对 arr 进行拷贝，不改变参数内容</span>
        <span class="kt">int</span><span class="o">[]</span> <span class="n">arr</span> <span class="o">=</span> <span class="nc">Arrays</span><span class="o">.</span><span class="na">copyOf</span><span class="o">(</span><span class="n">sourceArray</span><span class="o">,</span> <span class="n">sourceArray</span><span class="o">.</span><span class="na">length</span><span class="o">);</span>

        <span class="kt">int</span> <span class="n">len</span> <span class="o">=</span> <span class="n">arr</span><span class="o">.</span><span class="na">length</span><span class="o">;</span>
      
        <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">i</span> <span class="o">=</span> <span class="mi">0</span><span class="o">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="n">len</span><span class="o">;</span> <span class="n">i</span><span class="o">++)</span> <span class="o">{</span>
            <span class="n">heapInsert</span><span class="o">(</span><span class="n">arr</span><span class="o">,</span> <span class="n">i</span><span class="o">);</span>
        <span class="o">}</span>
        <span class="kt">int</span> <span class="n">size</span> <span class="o">=</span> <span class="n">arr</span><span class="o">.</span><span class="na">length</span><span class="o">;</span>
        <span class="k">while</span> <span class="o">(</span><span class="n">size</span> <span class="o">&gt;</span> <span class="mi">1</span><span class="o">)</span> <span class="o">{</span>
            <span class="n">swap</span><span class="o">(</span><span class="n">arr</span><span class="o">,</span><span class="mi">0</span><span class="o">,</span> <span class="o">--</span><span class="n">size</span><span class="o">);</span>
            <span class="n">heapify1</span><span class="o">(</span><span class="n">arr</span><span class="o">,</span><span class="mi">0</span><span class="o">,</span> <span class="n">size</span><span class="o">);</span>
        <span class="o">}</span>
        <span class="k">return</span> <span class="n">arr</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="c1">// i位置的数，向上调整大根堆</span>
    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">heapInsert</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">arr</span><span class="o">,</span> <span class="kt">int</span> <span class="n">i</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">while</span> <span class="o">(</span><span class="n">i</span> <span class="o">&gt;</span> <span class="mi">0</span> <span class="o">&amp;&amp;</span> <span class="n">arr</span><span class="o">[</span><span class="n">i</span><span class="o">]</span> <span class="o">&gt;</span> <span class="n">arr</span><span class="o">[(</span><span class="n">i</span> <span class="o">-</span> <span class="mi">1</span><span class="o">)</span> <span class="o">/</span> <span class="mi">2</span><span class="o">])</span> <span class="o">{</span>
            <span class="n">swap</span><span class="o">(</span><span class="n">arr</span><span class="o">,</span> <span class="n">i</span><span class="o">,</span> <span class="o">(</span><span class="n">i</span> <span class="o">-</span> <span class="mi">1</span><span class="o">)</span> <span class="o">/</span> <span class="mi">2</span><span class="o">);</span>
            <span class="n">i</span> <span class="o">=</span> <span class="o">(</span><span class="n">i</span> <span class="o">-</span> <span class="mi">1</span><span class="o">)</span> <span class="o">/</span> <span class="mi">2</span><span class="o">;</span>
        <span class="o">}</span>
    <span class="o">}</span>

    <span class="c1">// i位置的数，向下调整大根堆</span>
    <span class="c1">// 当前堆的大小为size</span>
    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">heapify1</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">arr</span><span class="o">,</span> <span class="kt">int</span> <span class="n">i</span><span class="o">,</span> <span class="kt">int</span> <span class="n">size</span><span class="o">)</span> <span class="o">{</span>
        <span class="kt">int</span> <span class="n">l</span> <span class="o">=</span> <span class="n">i</span> <span class="o">*</span> <span class="mi">2</span> <span class="o">+</span> <span class="mi">1</span><span class="o">;</span>
        <span class="k">while</span> <span class="o">(</span><span class="n">l</span> <span class="o">&lt;</span> <span class="n">size</span><span class="o">)</span> <span class="o">{</span>
            <span class="kt">int</span> <span class="n">best</span> <span class="o">=</span> <span class="n">l</span> <span class="o">+</span> <span class="mi">1</span> <span class="o">&lt;</span> <span class="n">size</span> <span class="o">&amp;&amp;</span> <span class="n">arr</span><span class="o">[</span><span class="n">l</span> <span class="o">+</span> <span class="mi">1</span><span class="o">]</span> <span class="o">&gt;</span> <span class="n">arr</span><span class="o">[</span><span class="n">l</span><span class="o">]</span> <span class="o">?</span> <span class="n">l</span> <span class="o">+</span> <span class="mi">1</span> <span class="o">:</span> <span class="n">l</span><span class="o">;</span>
            <span class="n">best</span> <span class="o">=</span> <span class="n">arr</span><span class="o">[</span><span class="n">best</span><span class="o">]</span> <span class="o">&gt;</span> <span class="n">arr</span><span class="o">[</span><span class="n">i</span><span class="o">]</span> <span class="o">?</span> <span class="n">best</span> <span class="o">:</span> <span class="n">i</span><span class="o">;</span>
            <span class="k">if</span> <span class="o">(</span><span class="n">best</span> <span class="o">==</span> <span class="n">i</span><span class="o">)</span> <span class="o">{</span>
                <span class="k">break</span><span class="o">;</span>
            <span class="o">}</span>
            <span class="n">swap</span><span class="o">(</span><span class="n">arr</span><span class="o">,</span> <span class="n">best</span><span class="o">,</span> <span class="n">i</span><span class="o">);</span>
            <span class="n">i</span> <span class="o">=</span> <span class="n">best</span><span class="o">;</span>
            <span class="n">l</span> <span class="o">=</span> <span class="n">i</span> <span class="o">*</span> <span class="mi">2</span> <span class="o">+</span> <span class="mi">1</span><span class="o">;</span>
        <span class="o">}</span>
    <span class="o">}</span>


    <span class="kd">private</span> <span class="kt">void</span> <span class="nf">swap</span><span class="o">(</span><span class="kt">int</span><span class="o">[]</span> <span class="n">arr</span><span class="o">,</span> <span class="kt">int</span> <span class="n">i</span><span class="o">,</span> <span class="kt">int</span> <span class="n">j</span><span class="o">)</span> <span class="o">{</span>
        <span class="kt">int</span> <span class="n">temp</span> <span class="o">=</span> <span class="n">arr</span><span class="o">[</span><span class="n">i</span><span class="o">];</span>
        <span class="n">arr</span><span class="o">[</span><span class="n">i</span><span class="o">]</span> <span class="o">=</span> <span class="n">arr</span><span class="o">[</span><span class="n">j</span><span class="o">];</span>
        <span class="n">arr</span><span class="o">[</span><span class="n">j</span><span class="o">]</span> <span class="o">=</span> <span class="n">temp</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<h2 id="桶排序">桶排序</h2>

<p>待续……</p>

<h2 id="基数排序">基数排序</h2>

<p>待续……</p>]]></content><author><name>Xudu</name></author><category term="算法" /><category term="algorithm" /><category term="sort" /><summary type="html"><![CDATA[排序算法]]></summary></entry><entry><title type="html">GCR：用知识图谱约束大模型的推理路径</title><link href="https://xuduyinuo.cn/GCR/" rel="alternate" type="text/html" title="GCR：用知识图谱约束大模型的推理路径" /><published>2025-11-14T18:56:20+08:00</published><updated>2025-11-14T18:56:20+08:00</updated><id>https://xuduyinuo.cn/GCR</id><content type="html" xml:base="https://xuduyinuo.cn/GCR/"><![CDATA[<p>将知识图谱编码为 KG-Trie，在解码时约束模型生成真实存在的图谱路径。这篇笔记梳理 GCR 如何结合小模型的图推理与大模型的归纳能力，生成有据可循的答案。</p>

<!-- more -->

<h1 id="source">Source</h1>

<p>论文原题：<strong>Graph-constrained Reasoning: Faithful Reasoning on Knowledge Graphs with Large Language Models</strong></p>

<p>paper link: https://icml.cc/virtual/2025/poster/45868</p>

<p>Code and data are available at: https://github.com/RManLuo/graph-constrained-reasoning</p>

<h1 id="motivation">Motivation</h1>

<ol>
  <li>LLM由于幻觉问题和缺乏特定领域的知识，推理的可靠性不足。</li>
  <li>现有的KG增强LLM的方法（基于检索和基于代理的方法），难以准确的从KG中检索知识。</li>
</ol>

<h1 id="contribution">Contribution</h1>

<ol>
  <li>提出GCR框架</li>
  <li>结合微调的”小“模型的图推理能力和通用大模型的归纳推理能力增强框架的推理性能</li>
  <li>在RoG-webqsp和RoG-cwq等五个数据集上进行实验，证明了GCR实现了零幻觉且在当时达到了SOTA。（在无需训练的情况下，在零样本提示中具有广泛的通用性）</li>
</ol>

<h1 id="approach">Approach</h1>

<h2 id="graph-constrained-reasoning-gcr">Graph-constrained Reasoning (GCR)</h2>

<p>将KGs直接引入LLMs的解码过程，实现可靠推理。</p>

<p>由三个主要部分组成：1）知识图Trie构造 2）图约束解码 3）图归纳推理</p>

<p>GCR的总体框架如下图（c）所示：</p>

<p><img src="../images/GCR/GCR%E6%A1%86%E6%9E%B6%E5%9B%BE.webp" alt="GCR框架图" /></p>

<h2 id="knowledge-graph-trie-construction">Knowledge Graph Trie Construction</h2>

<p>因为知识图谱结构化的特性，LLM难以有效进行推理。</p>

<p>作者提出将KG的结构化知识转化为KG-Trie（知识图谱前缀树）索引，来应用于LLM的解码过程，促进LLM的推理能力。</p>

<p>方法：给定一个KG和问题及主题实体。</p>

<ol>
  <li>从主题实体开始，使用图遍历算法在KG中遍历固定跳数的推理路径</li>
  <li>将搜索到的推理路径转化为自然语言句子</li>
  <li>使用LLM的分词器工具将自然语言句子转换为token并存储在KG-Trie中</li>
</ol>

<p>形式化为如下公式：</p>

<p><img src="../images/GCR/build_KG_trie.webp" alt="build_KG_trie" /></p>

<h2 id="graph-constrained-decoding">Graph-constrained Decoding</h2>

<p>给定一个问题Q，通过提示一个经过微调之后的轻量化的小模型，在LLM解码时使用上一步骤中得到的KG-Trie作约束，保证LLM生成的推理路径都是KG中存在的有效的真实的路径。</p>

<p>LLM每次通过图约束解码得到有效的推理路径之后再切换回常规解码，生成以路径为条件的假设答案。</p>

<p><img src="../images/GCR/Graph-constrained-Decoding.webp" alt="" /></p>

<p>微调轻量化小模型方法：</p>

<p>训练数据中包含问题、问题实体、答案实体和问题相关知识图谱三元组</p>

<p>先将知识图谱三元组转化为图结构，再使用最短路径算法连接问题实体和答案实体，使其连接的路径作为该问题的推理路径。</p>

<p>作者实验标明，使用微调的轻量化小模型也能得到良好的推理性能。</p>

<blockquote>
  <p>图约束解码方法不同于基于检索的解码方法，它将预先构造的KG-Trie集成到LLMs的解码过程中。这不仅减少了输入token，而且弥补了LLMs中的非结构化推理和KGs中的结构化知识之间的差距，允许在KGs上进行有效的推理，而不管其规模大小，这将导致可靠的推理，从而得到答案。</p>
</blockquote>

<h2 id="graph-inductive-reasoning">Graph Inductive Reasoning</h2>

<p>通过提示小模型得到该问题的多条推理路径和假设答案，再将这些推理路径和假设答案输入给一个强大的通用大模型，通过大模型及其内部知识进行归纳整理得到最终的答案。</p>

<p><img src="../images/GCR/Graph-Inductive-Reasoning.webp" alt="Graph-Inductive-Reasoning" /></p>

<h1 id="experiment">Experiment</h1>

<h2 id="思路学习">思路学习</h2>

<p>对实验步骤进行客观陈述，数据集、baseline、评估指标、实现过程等</p>

<p>说明你的实验具有什么效果，和基线相比有什么突出点</p>

<p>你的实验结果怎么和你的创新点相关联</p>

<p>基本：</p>

<p>可以在实验之前通过问题的方式告诉自己都需要做什么实验</p>

<p>通过实验告诉读者，你提出的框架或模型和基线相比有什么不同、提升……</p>

<p>通过实验告诉读者，你提出的框架或模型解决了什么问题</p>

<p>通过实验告诉读者，你提出的框架或模型可以怎么扩展，或应用在哪些下游任务……</p>

<h2 id="implementations">Implementations</h2>

<p>我们使用KG-Trie索引从问题实体开始的2个跳内的所有推理路径。对于LLM，我们使用微调Llama3-8B 作为KG专用LLM。我们通过图约束解码生成前10条推理路径和假设答案。我们采用ChatGPT和GPT-4o-mini作为归纳推理的通用LLMs。</p>

<h2 id="result">Result</h2>

<p><img src="../images/GCR/result.webp" alt="result" /></p>

<h1 id="conclusion">Conclusion</h1>

<p>提出了一种新的LLM推理范式，称为图约束推理（GCR），通过引入结构化KG来消除幻觉，保证推理的可靠性。</p>

<p>为了将LLMs中的非结构化推理与KGs中的结构化知识联系起来，我们提出了一种KG-Trie，利用基于Trie的索引对KGs中的路径进行编码。</p>

<p>使用大小模型协同作用，结合图推理和归纳推理生成最终答案。</p>]]></content><author><name>Xudu</name></author><category term="论文笔记" /><category term="LLM" /><category term="Knowledge Graph" /><category term="KG-Trie" /><summary type="html"><![CDATA[将知识图谱编码为 KG-Trie，在解码时约束模型生成真实存在的图谱路径。这篇笔记梳理 GCR 如何结合小模型的图推理与大模型的归纳能力，生成有据可循的答案。]]></summary></entry></feed>